








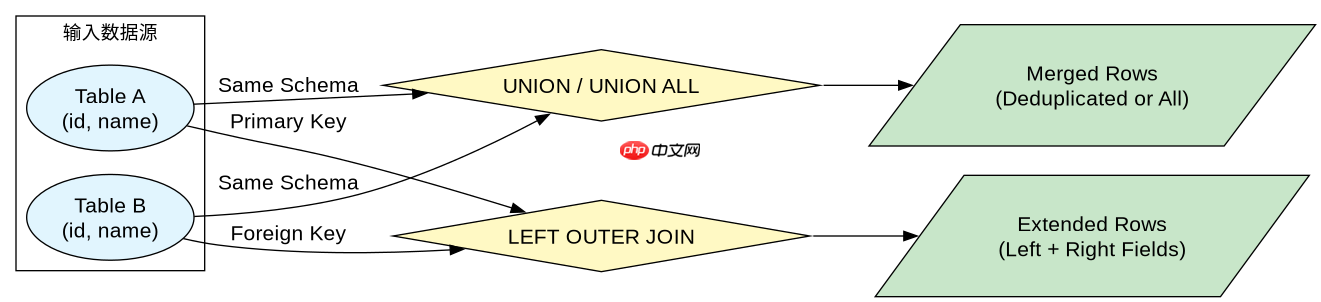
判断的核心依据是数据关系的本质:如果目的是合并两个结构相同但互不重叠的结果集,应使用 union;如果目的是基于关联条件保留左表所有记录并匹配右表数据,应使用 outer join。具体做法是检查输入数据的来源和预期输出:若两表无共同键值且需去重合并行,用 union;若需以主表为基准扩展字段,即使匹配不到也保留主表行,用 left outer join。
当需要合并不同来源的同类数据时该怎么做
在需要将两个具有相同列结构的查询结果纵向拼接时,必须使用 UNION 或 UNION ALL。这通常发生在数据来自不同的分区、不同的表或不同的业务逻辑分支,但最终展示给用户的是一整份列表。使用 UNION 会自动去除重复行,而 UNION ALL 则保留所有行以提升性能。关键在于两部分的 SELECT 语句列数和数据类型必须兼容。
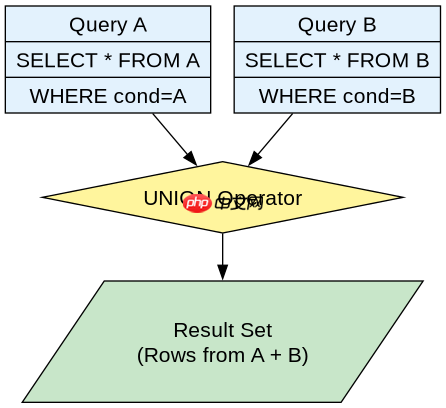
SELECT id, name, 'Source A' as source FROM table_a WHERE status = 1
UNION
SELECT id, name, 'Source B' as source FROM table_b WHERE status = 1;
上述代码将 table_a 和 table_b 中状态为 1 的记录合并。由于使用了 UNION,如果两张表中存在完全相同的 id 和 name 组合,结果集中只会保留一条。若希望保留所有原始记录,包括重复项,应将 UNION 替换为 UNION ALL。此操作不涉及任何键值的匹配,纯粹是行的堆叠。
当需要基于主表保留所有记录并补充关联信息时该怎么做
当需要以一张表为主,获取其所有记录,并根据条件从另一张表中补充相关字段时,必须使用 OUTER JOIN(通常是 LEFT OUTER JOIN)。这与 INNER JOIN 不同,后者只返回两边都能匹配上的记录,而 OUTER JOIN 保证左表的所有行都出现在结果中。如果右表没有匹配的数据,对应字段将填充为 NULL。这是报表生成、用户详情扩展等场景的标准做法。
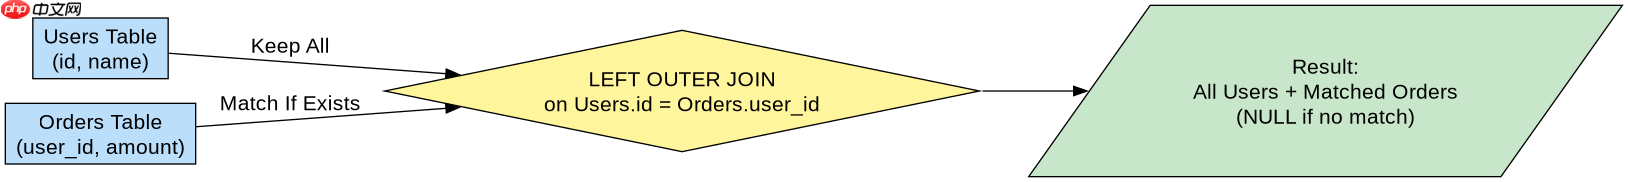
SELECT u.id, u.name, o.order_id, o.amount
FROM users u
LEFT OUTER JOIN orders o ON u.id = o.user_id;
这段代码确保 users 表中的每个用户都会出现在结果里,无论他们是否有订单。如果用户没有订单,order_id 和 amount 将为 NULL。这种操作是基于外键关系的横向扩展,而非纵向合并。如果错误地使用了 UNION,将无法实现这种基于键值的字段补充,因为 UNION 要求列结构完全一致,无法动态填充缺失的关联字段。
当右表匹配不到数据时OUTER JOIN会返回什么
在使用 LEFT OUTER JOIN 时,如果左表的某行在右表中找不到匹配的记录,该左表行依然会被保留,但右表对应的所有列值都会变为 NULL。这一行为对于处理“可选”关联数据至关重要。例如,在一个包含用户及其订单的场景中,未下单的用户依然会在结果集中出现,只是订单相关字段为空。开发者可以通过检查这些 NULL 值来识别未匹配的记录,或者在应用层进行默认值填充。这种机制确保了主数据的完整性不被关联数据的缺失所破坏。


















