








腾讯于11月18日开放hy4 flash模型权重,提供指令模型、fp8版本和基础预训练模型。当前模型卡列出220b总参数,其中包含约64b engram参数,每个token激活约12b参数;模型接受文本和图像输入、生成文本,支持最高约100万token上下文。三个版本的用途不同,基础模型不能直接视为已完成指令对齐的聊天模型。
12B活跃参数不等于只需存放12B权重
Hy4 flash采用42层语言骨干,包含1层稠密前馈层与41层混合专家层。模型卡将Engram计入总参数;每个Token只激活部分计算路径,可以减少单步计算,但部署仍要安排完整权重、缓存和相关内存资源。不能凭12B活跃参数推断普通12B模型的显存需求。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
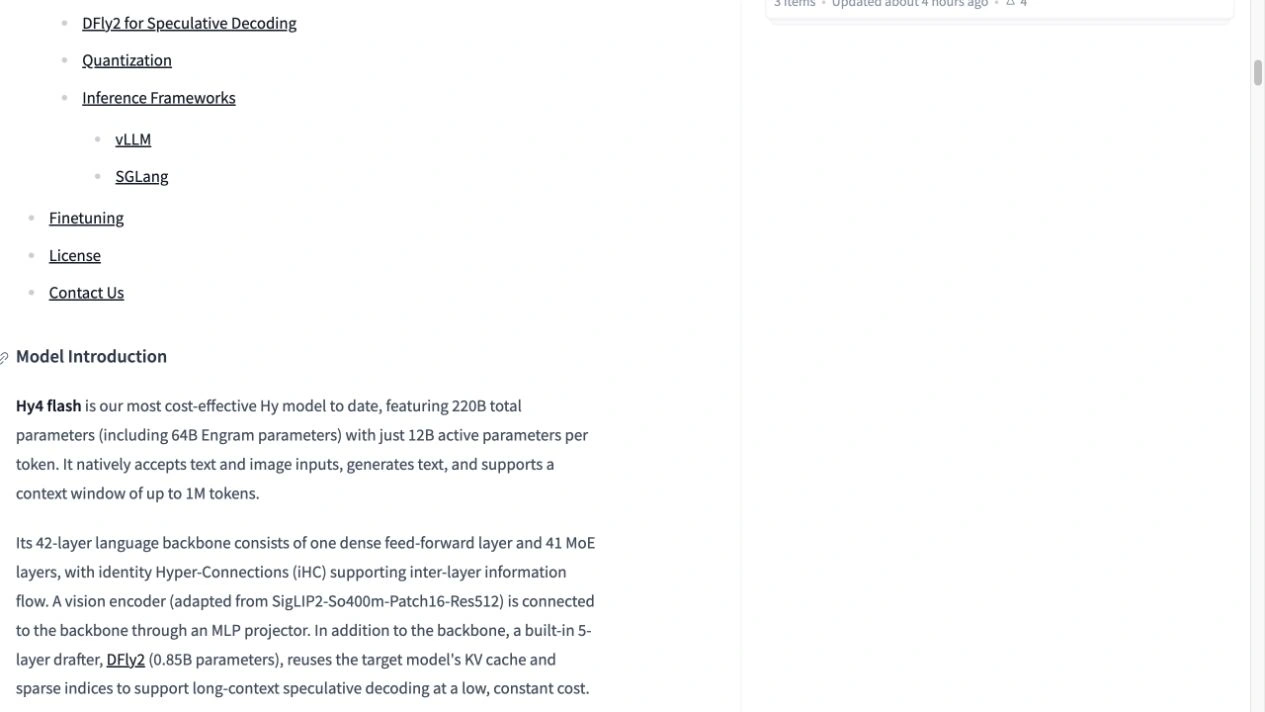
腾讯当前模型卡列出的参数与输入输出范围。
DFly2复用目标模型缓存
模型内置约0.85B参数、5层结构的DFly2草稿器,用于推测解码。它复用目标模型的KV缓存和稀疏索引,以较低额外成本生成候选Token,再由目标模型验证。该机制与直接使用另一套独立小模型作草稿器不同,实际吞吐仍受硬件、上下文和并发配置影响。
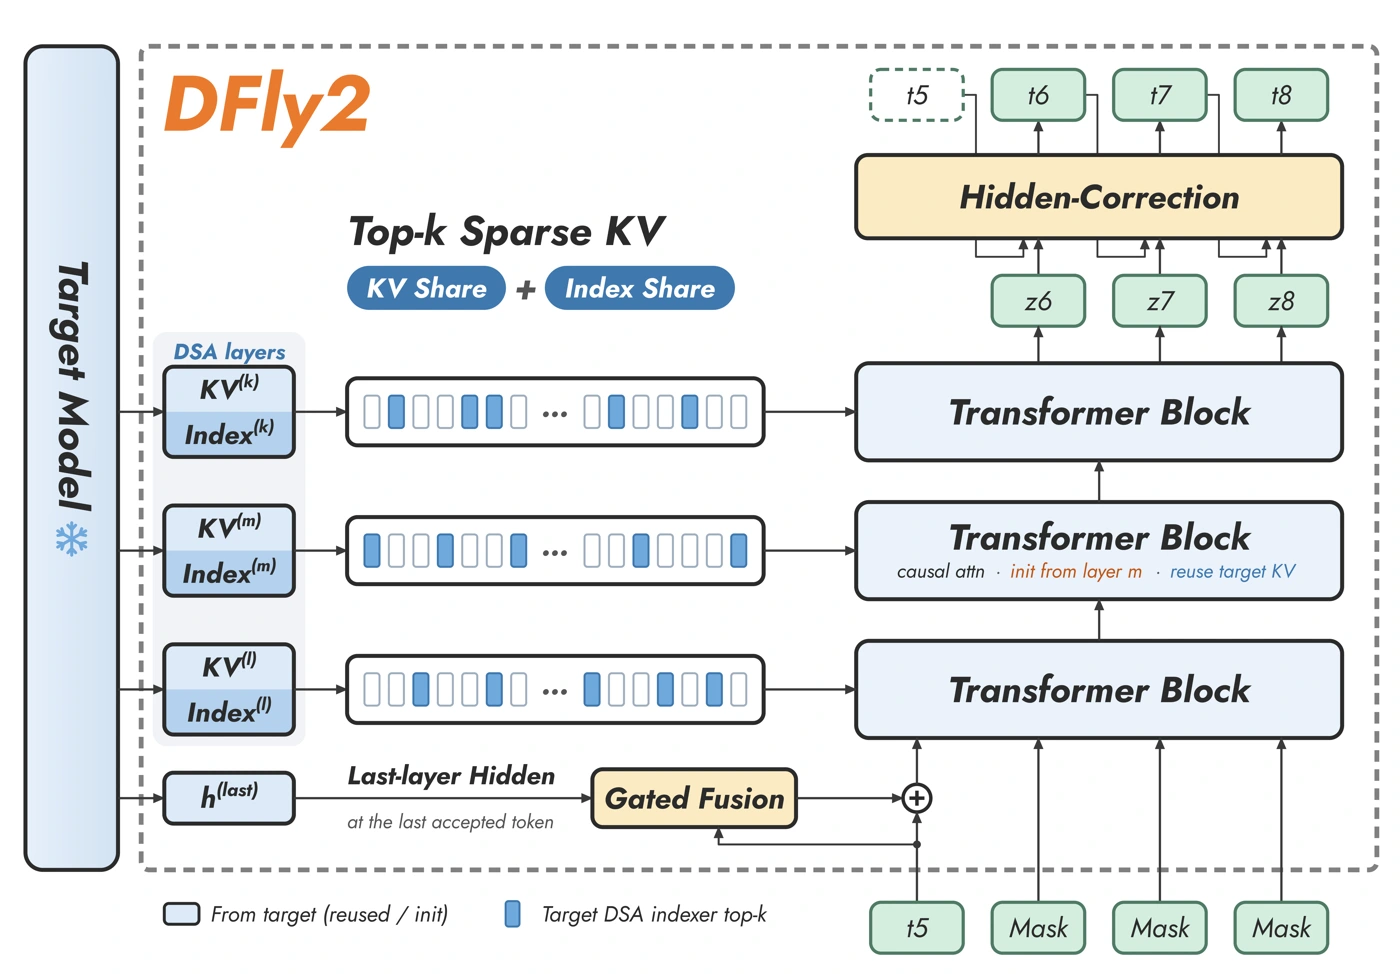
官方结构图展示目标模型、草稿器与缓存之间的关系。
部署需要对应框架分支与镜像
官方目前给出vLLM和SGLang的专用镜像,以及Transformers开发分支接入方式。不能仅安装当时的正式版Python包就认定已具备完整支持。FP8版本用于量化推理;基础模型面向后续训练或研究,选择前应核对模型卡和部署配方。
权重采用Tencent Hy License 1.0,使用和分发应遵守其条款。本次开放权重与此前Hy4在线服务发布属于不同交付形式,不能据此推断所有在线套餐、区域和计费条件也发生变化。
























