








2.3.2 通过调整系统提示的发送位置,修复多步会话中重复按未缓存输入计费的问题;网页抓取的结构化结果也删除了重复的调用参数。缓存收益仍取决于实际使用的路由、模型和请求,不能把单一案例当成所有场景的固定降费比例。
缓存修复改在哪里?
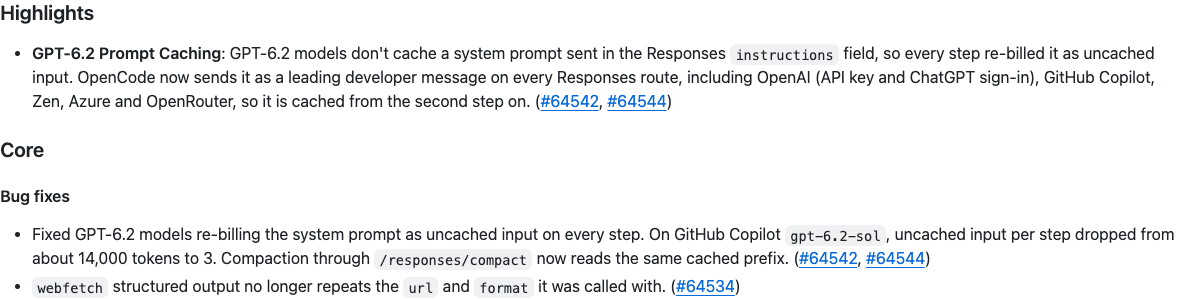
OpenCode 的发布说明指出,GPT-6.2 模型不会缓存通过 Responses 的 instructions 字段传递的系统提示。多步任务反复带上相同提示时,这部分内容原先仍按未缓存输入处理。2.3.2 改为把它放在开头的 developer 消息中,让相同前缀从第二步起能够进入缓存。
这项调整覆盖使用 Responses 的相关路由,包括 OpenAI 的 API 密钥与 ChatGPT 登录方式,以及 GitHub Copilot、Zen、Azure 和 OpenRouter。它是请求组织方式的修正,并不意味着首个请求也能直接命中已存在的缓存。
官方给出的令牌数字该怎么理解?
官方列出的例子是 GitHub Copilot 的 gpt-6.2-sol:每步未缓存输入从约 14,000 个令牌降到 3 个。这个数字描述特定场景中的未缓存部分,不是整个请求只剩 3 个令牌,也不是所有提供方的账单都会按同一比例下降。缓存输入、动态用户内容和输出仍应按对应服务的实际用量理解。
同一条修复还说明,/responses/compact 的压缩过程现在读取相同的缓存前缀。因此关注长会话成本时,需要把普通推理步骤和压缩过程一起区分,不能只看一次请求的总输入。
webfetch 输出有什么不同?
webfetch 的结构化输出不再重复返回调用时已经给出的 url 和 format。它针对结果中的冗余字段,并未宣称网页内容提取准确率、访问权限或网络速度发生提升。依赖工具结果做后续处理时,应把调用参数与返回内容分开理解,避免将这些字段的省略误判为网页正文缺失。
哪些使用方式更相关?
主要变化与使用 GPT-6.2 的多步任务和 Responses 路由相关。若当前会话采用其他模型或其他接口,发布说明没有给出相同收益的保证。2.3.2 已作为正式版本提供分发文件;发布页面关联的开发分支提交数量不等于这些后续提交已经包含在 2.3.2 安装包中。
























