








java 线程池使用工作窃取算法提升效率的核心做法是引入 forkjoinpool 并配合 forkjointask 进行任务拆分。通过将大任务递归拆分为小任务,并利用空闲线程从忙碌线程的任务队列尾部“窃取”任务,可以有效平衡各线程的工作负载,减少线程阻塞和上下文切换开销。
ForkJoinPool 如何初始化与配置并行度?
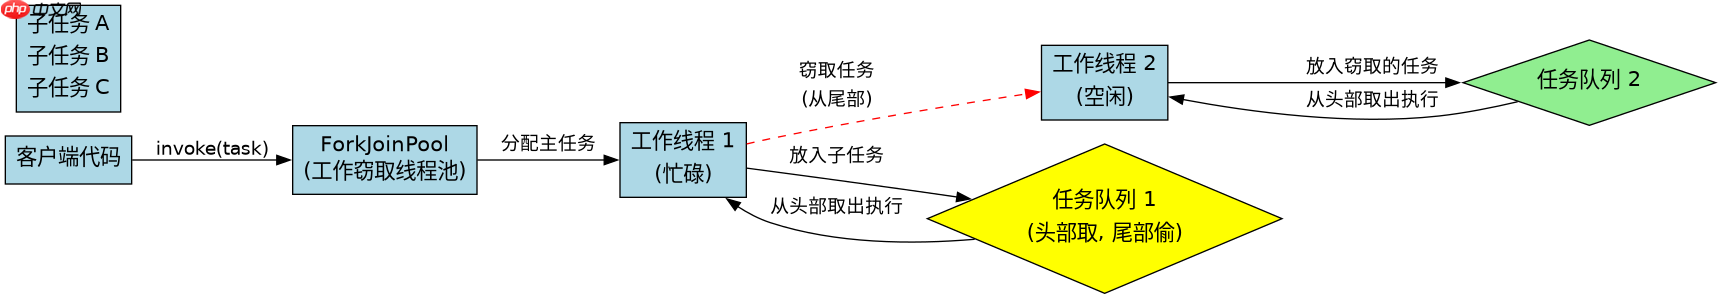
ForkJoinPool 的默认并行度等于当前机器的 CPU 核心数,通常无需手动指定即可满足大多数场景。若需自定义,可通过构造函数传入目标并行度参数。初始化后,线程池会自动管理一组工作线程,这些线程共享一个全局的双端队列(Work-Stealing Queue),这是实现工作窃取的基础数据结构。
import java.util.concurrent.ForkJoinPool;
import java.util.concurrent.RecursiveTask;

public class Main {
    public static void main(String[] args) {
        // 创建 ForkJoinPool,并行度设为 CPU 核心数
        ForkJoinPool pool = new ForkJoinPool();

        // 提交一个大任务
        SumTask task = new SumTask(0, 1000000);
        Long result = pool.invoke(task);

        System.out.println("Result: " + result);
        pool.shutdown();
    }
}
如何实现任务的递归拆分与合并?
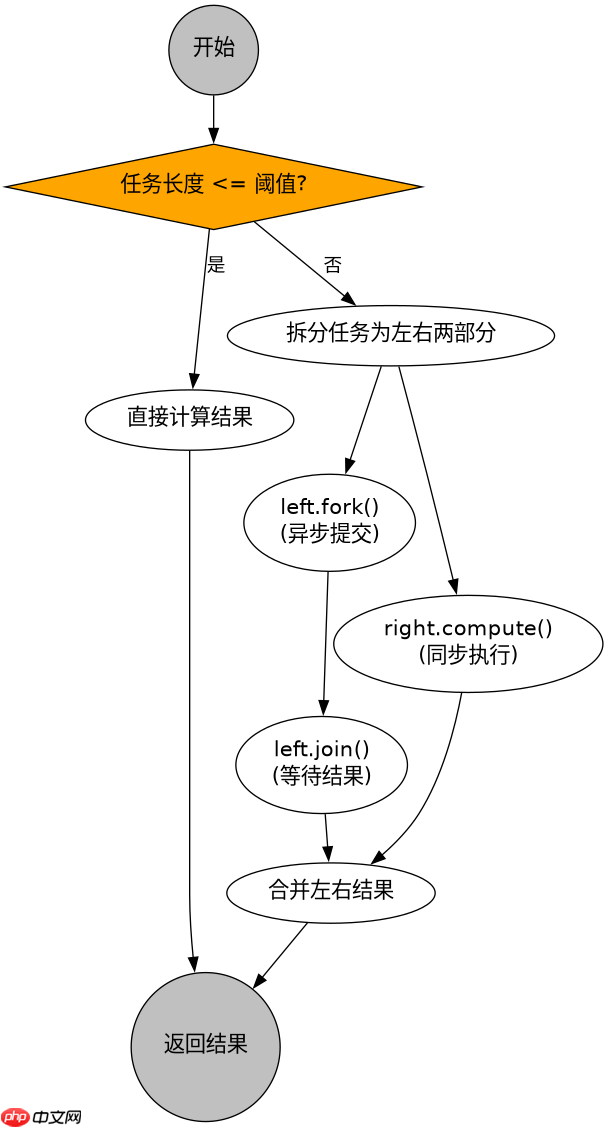
要实现工作窃取,必须将计算任务继承自 RecursiveTask(有返回值)或 RecursiveAction(无返回值)。在 compute() 方法中,判断任务规模是否小于阈值。如果大于阈值,则使用 fork() 将子任务异步提交到当前线程的队列中,并同步执行另一个子任务;如果小于阈值,则直接顺序计算。这种分治策略确保了任务被细粒度化,增加了被窃取的概率。

立即学习“Java免费学习笔记(深入)”;
import java.util.concurrent.RecursiveTask;

public class SumTask extends RecursiveTask<Long> {
    private static final int THRESHOLD = 10000;
    private long start;
    private long end;

    public SumTask(long start, long end) {
        this.start = start;
        this.end = end;
    }

    @Override
    protected Long compute() {
        long length = end - start;
        if (length <= THRESHOLD) {
            // 任务足够小,直接计算
            long sum = 0;
            for (long i = start; i < end; i++) {
                sum += i;
            }
            return sum;
        } else {
            // 任务较大,拆分为两个子任务
            long mid = (start + end) / 2;
            SumTask left = new SumTask(start, mid);
            SumTask right = new SumTask(mid, end);

            left.fork(); // 异步执行左子任务
            long rightResult = right.compute(); // 同步执行右子任务

            return left.join() + rightResult; // 合并结果
        }
    }
}
当子任务执行时间不均时,工作窃取如何避免线程饥饿?
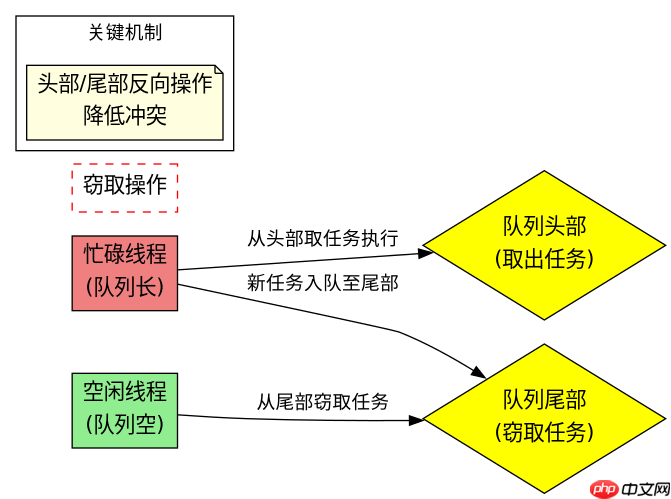
在任务拆分不均匀的情况下,某些线程可能快速完成自己的任务队列而闲置,而其他线程仍忙于处理大量剩余任务。此时,空闲线程会尝试从忙碌线程的双端队列尾部窃取任务。由于忙碌线程通常从头部取出任务执行,空闲线程从尾部窃取,两者操作方向相反,极大减少了锁竞争。这种机制确保了即使任务分布不均,所有 CPU 核心也能保持高利用率,避免部分线程饥饿。

















