








HikariConfig 设置 maximumPoolSize 的具体方法是什么
在 java 中使用 hikaricp 配置连接池大小时,需要实例化 hikariconfig 对象并调用其 setmaximumpoolsize() 方法。该参数直接控制池中允许存在的物理数据库连接的最大数量,默认值为 10。开发者只需传入一个正整数即可生效,无需额外计算或复杂逻辑。

import com.zaxxer.hikari.HikariConfig;
import com.zaxxer.hikari.HikariDataSource;

public class PoolConfigExample {
    public static void main(String[] args) {
        // 1. 创建配置对象
        HikariConfig config = new HikariConfig();

        // 2. 设置基本 JDBC 信息
        config.setJdbcUrl("jdbc:mysql://localhost:3306/mydb");
        config.setUsername("user");
        config.setPassword("password");

        // 3. 核心:设置最大连接池大小
        // 假设我们需要最多 20 个并发连接
        int maxPoolSize = 20;
        config.setMaximumPoolSize(maxPoolSize);

        // 4. 构建数据源
        HikariDataSource dataSource = new HikariDataSource(config);

        System.out.println("当前配置的最大连接数: " + dataSource.getMaximumPoolSize());

        // 使用完毕后关闭
        dataSource.close();
    }
}
上述代码展示了最基础的配置流程。关键点在于 setMaximumPoolSize() 的调用时机必须在 HikariDataSource 构造之前。如果未显式设置,HikariCP 会使用默认值 10。对于大多数中小型应用,这个默认值通常足够;但对于高并发场景,需要根据实际业务负载调整该值。
如何根据 CPU 核心数和 IO 特性计算合适的连接池大小
连接池大小的设定并非随意猜测,而是基于系统的 CPU 核心数和数据库操作的 IO 特性来计算的。对于典型的数据库操作(CPU 密集型与 IO 密集型混合),可以使用经验公式:核心数 * (1 + 等待时间 / 计算时间)。由于数据库连接获取和释放涉及网络 IO 和磁盘 IO,等待时间通常远大于计算时间,因此连接数往往需要显著高于 CPU 核心数才能充分利用带宽。
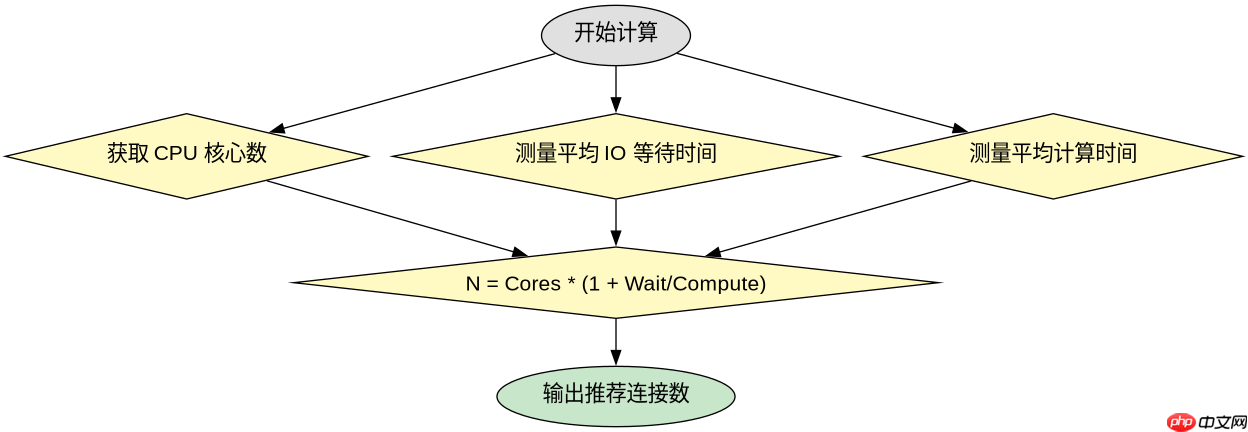

立即学习“Java免费学习笔记(深入)”;
import java.lang.management.ManagementFactory;
import com.sun.management.OperatingSystemMXBean;

public class PoolCalculator {
    public static void main(String[] args) {
        // 获取 CPU 核心数
        Runtime runtime = Runtime.getRuntime();
        int cpuCores = runtime.availableProcessors();

        // 模拟计算:假设平均查询耗时 50ms,IO 等待耗时 450ms
        double computeTime = 50.0;
        double waitTime = 450.0;

        // 应用公式:N = Cores * (1 + Wait/Compute)
        double recommendedSize = cpuCores * (1 + (waitTime / computeTime));

        // 向上取整并转换为整数
        int optimalPoolSize = (int) Math.ceil(recommendedSize);

        System.out.println("CPU 核心数: " + cpuCores);
        System.out.println("推荐连接池大小: " + optimalPoolSize);

        // 将此值应用到 HikariConfig
        HikariConfig config = new HikariConfig();
        config.setMaximumPoolSize(optimalPoolSize);
    }
}
在实际开发中,建议先通过压测确定当前的平均响应时间和吞吐量,然后代入上述公式得出初始值。需要注意的是,连接池过大并不会线性提升性能,反而可能增加上下文切换开销和数据库服务器的负载。因此,计算出的值应作为上限参考,并结合监控数据进行微调。
当连接池耗尽时程序的行为及排查方法
当所有连接都被占用且达到 maximumPoolSize 限制时,新请求会进入等待队列。如果等待超时(由 connectionTimeout 控制),程序将抛出 SQLException 或 SQLTransientException,具体取决于驱动实现。此时应用可能出现服务不可用或响应缓慢的情况。排查此类问题需关注线程堆栈、连接泄漏以及慢 SQL 语句。
import com.zaxxer.hikari.HikariConfig;
import com.zaxxer.hikari.HikariDataSource;
import java.sql.Connection;
import java.sql.SQLException;

public class ConnectionLeakTest {
    public static void main(String[] args) throws SQLException {
        HikariConfig config = new HikariConfig();
        config.setJdbcUrl("jdbc:mysql://localhost:3306/mydb");
        config.setUsername("user");
        config.setPassword("password");

        // 设置较小的连接池以便复现耗尽场景
        config.setMaximumPoolSize(2);
        // 设置超时时间为 5 秒
        config.setConnectionTimeout(5000);

        HikariDataSource ds = new HikariDataSource(config);

        // 模拟连接泄漏:获取连接但不关闭
        try (Connection conn1 = ds.getConnection()) {
            try (Connection conn2 = ds.getConnection()) {
                // 此时池已满,第三个请求将阻塞并超时
                try (Connection conn3 = ds.getConnection()) {
                    System.out.println("Should not reach here");
                } catch (SQLException e) {
                    System.out.println("Expected timeout: " + e.getMessage());
                }
            }
            // conn2 未关闭,导致泄漏
        }
        // conn1 已关闭

        ds.close();
    }
}
在上述测试代码中,我们故意不关闭 conn2,导致连接池迅速耗尽。第三个 getConnection() 调用会在 5 秒后抛出异常。生产环境中,应启用 leakDetectionThreshold 来检测潜在的连接泄漏。例如,设置 config.setLeakDetectionThreshold(30000); 可在连接持有超过 30 秒时记录警告日志,帮助定位未正确关闭连接的代码位置。

















