








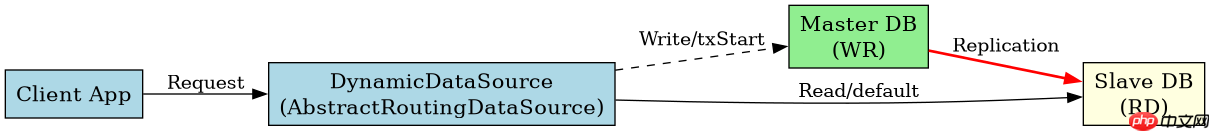
java jdbc 本身并不直接实现数据库层面的主从复制,而是通过配置多个数据源并配合事务管理器(如 spring 的 @transactional)来实现读写分离。具体做法是定义一个主数据源用于写操作,一个或多个从数据源用于读操作,并在代码中根据业务需求显式或隐式地切换数据源。这样,写入事务在主库执行以保证强一致性,而读取操作可以路由到从库以分担压力。
如何配置多数据源以实现读写分离
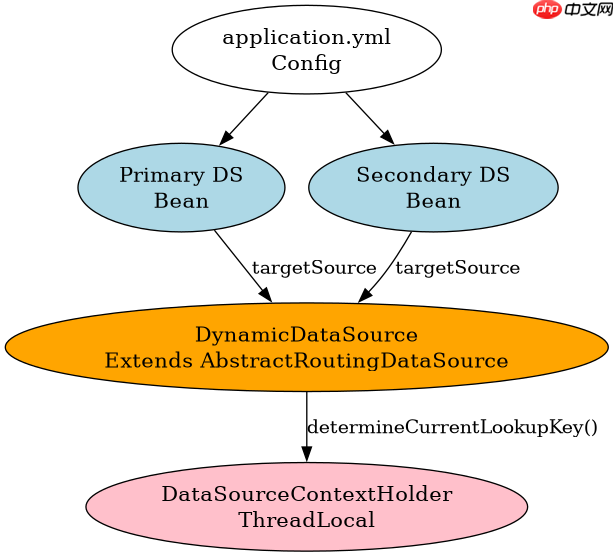
要实现读写分离,核心在于创建两个独立的数据源实例:一个指向主库,一个指向从库。在 Spring Boot 应用中,通常通过 application.yml 分别配置这两个数据源的连接信息,并使用 @Configuration 类将它们注册为 Bean。关键在于自定义一个 AbstractRoutingDataSource,它会根据当前线程中的标记决定将请求路由到哪个数据源。默认情况下,所有查询都走从库,而一旦进入写方法,就切换到主库。
import org.springframework.jdbc.datasource.lookup.AbstractRoutingDataSource;

public class DynamicDataSource extends AbstractRoutingDataSource {
    @Override
    protected Object determineCurrentLookupKey() {
        return DataSourceContextHolder.getDbType();
    }
}
上述代码展示了动态数据源的核心逻辑。在实际使用中,你需要在 Service 层的写方法上添加 @Transactional 注解,并在事务开始前通过 AOP 或手动调用将上下文设置为 MASTER。事务提交后,再重置为 SLAVE。这种机制确保了在同一事务内,所有的读写操作都发生在同一个物理连接上,避免了因跨库切换导致的事务不一致问题。
立即学习“Java免费学习笔记(深入)”;

事务传播行为对主从一致性的影响
在使用多数据源进行读写分离时,事务的传播行为至关重要。如果读操作和写操作被错误地分配到不同的事务中,或者读操作在没有事务保护的情况下执行,可能会导致“脏读”或读到未提交的数据。因此,必须确保写操作所在的 @Transactional 事务能够正确锁定主库资源,并且在该事务范围内,后续的读操作也应优先从主库读取,以确保看到最新的数据。

@Service
public class OrderService {
    @Autowired
    private OrderRepository orderRepo;

    @Transactional
    public void createOrder(Order order) {
        // 强制使用主库
        DataSourceContextHolder.setDbType(DataSourceType.MASTER);
        orderRepo.save(order);

        // 在同一事务内,后续读取也应在主库
        Order saved = orderRepo.findById(order.getId());
        System.out.println(saved.getStatus());
    }
}
这段代码演示了在一个事务内部,先写入订单,然后立即读取该订单的状态。由于 createOrder 方法标注了 @Transactional,Spring 会管理这个事务的生命周期。在事务开始时,我们手动将数据源上下文设为 MASTER。这意味着 save 操作会在主库执行,而随后的 findById 也会因为上下文未变而在主库执行,从而保证了读取到的数据是刚刚写入且已提交的,避免了主从延迟带来的数据不一致风险。
主从延迟场景下如何保证读取最新数据
即使配置了读写分离,主从复制也存在网络延迟,导致从库数据滞后。如果在高并发场景下,用户刚写完数据就立刻去读,可能会从从库读到旧数据。解决这个问题的最直接方法是在写操作后的短时间内,强制将读请求也路由到主库。这可以通过在事务上下文中设置一个标志位,或者使用本地缓存来暂存最新写入的数据,直到从库同步完成后再允许读取从库。



















