








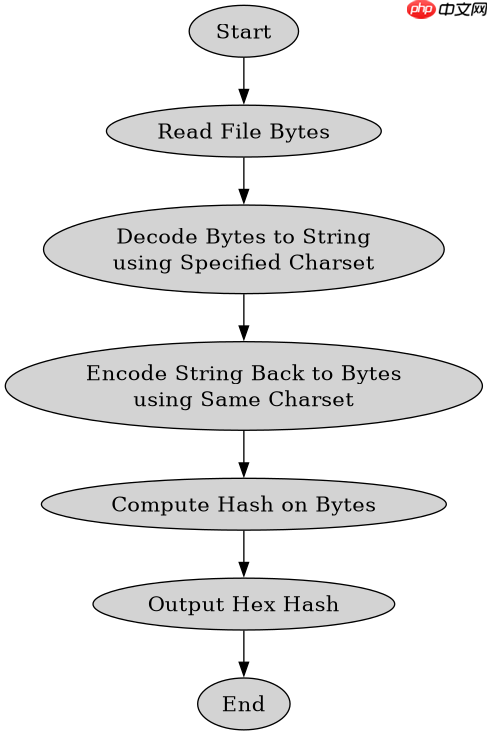
使用编码哈希校验文件完整性的核心做法是:读取文件字节流,通过指定字符集(如 utf-8)解码为字符串,再对字符串计算哈希值。由于不同编码对同一字节序列的解析结果可能不同,必须明确指定编码格式以确保哈希的一致性。具体实现时,需先获取文件的原始字节,将其转换为指定编码的 string 对象,最后调用 messagedigest 等工具计算该字符串对应字节数组的哈希摘要。

如何正确将文件字节转换为指定编码的字符串
要将文件内容作为字符串进行哈希计算,必须先将其从字节流转换为 Java 的 String 对象。关键在于使用正确的字符集构造函数,避免依赖平台默认编码导致跨环境不一致。例如,使用 new String(bytes, StandardCharsets.UTF_8) 可确保在任何平台上都按 UTF-8 规则解析字节。若文件包含非 UTF-8 兼容字符,强制使用 UTF-8 可能导致替换字符或异常,因此需根据文件实际来源选择编码。转换后的字符串内部存储为 Unicode,其底层字节表示取决于后续哈希计算时的编码方式。
import java.io.*;
import java.nio.charset.StandardCharsets;
import java.security.MessageDigest;

public class EncodingHash {
    public static void main(String[] args) throws Exception {
        // 模拟一个包含中文的文件字节数组
        byte[] fileBytes = "测试".getBytes(StandardCharsets.UTF_8);

        // 步骤1: 将字节按 UTF-8 解码为字符串
        String content = new String(fileBytes, StandardCharsets.UTF_8);

        // 步骤2: 将字符串重新编码回字节数组以计算哈希
        byte[] hashInput = content.getBytes(StandardCharsets.UTF_8);

        // 步骤3: 计算 SHA-256 哈希
        MessageDigest md = MessageDigest.getInstance("SHA-256");
        byte[] digest = md.digest(hashInput);

        System.out.println("Hex Hash: " + bytesToHex(digest));
    }

    private static String bytesToHex(byte[] bytes) {
        StringBuilder sb = new StringBuilder();
        for (byte b : bytes) {
            sb.append(String.format("%02x", b));
        }
        return sb.toString();
    }
}上述代码中,fileBytes 是原始文件内容,content 是解码后的字符串,hashInput 是用于哈希计算的字节数组。最终输出的 Hex Hash 即为校验值。若更改解码或编码的字符集,哈希结果将完全不同。
立即学习“Java免费学习笔记(深入)”;

编码差异如何影响哈希结果的唯一性
不同字符编码对相同字节序列的解析结果不同,导致生成的字符串及后续哈希值存在显著差异。例如,GBK 和 UTF-8 对中文“测”字的字节表示不同,解码后的 Unicode 码位虽相同,但若在哈希计算前未统一编码,直接对原始字节或错误编码的字符串计算哈希,会导致校验失败。此外,某些编码(如 UTF-16)会引入 BOM(字节顺序标记),若未处理,BOM 字节会被纳入哈希计算,进一步改变结果。因此,校验时必须确保发送方和接收方使用完全相同的编码策略,包括是否忽略 BOM、是否处理无效字节等细节。

import java.io.*;
import java.nio.charset.StandardCharsets;
import java.security.MessageDigest;

public class EncodingComparison {
    public static void main(String[] args) throws Exception {
        byte[] rawBytes = "A中".getBytes(StandardCharsets.UTF_8);

        // 场景1: UTF-8 解码后 UTF-8 编码
        String utf8Str = new String(rawBytes, StandardCharsets.UTF_8);
        byte[] utf8HashInput = utf8Str.getBytes(StandardCharsets.UTF_8);
        byte[] utf8Digest = MessageDigest.getInstance("SHA-256").digest(utf8HashInput);

        // 场景2: GBK 解码后 UTF-8 编码(假设原始字节能被 GBK 解析)
        try {
            String gbkStr = new String(rawBytes, StandardCharsets.GBK);
            byte[] gbkHashInput = gbkStr.getBytes(StandardCharsets.UTF_8);
            byte[] gbkDigest = MessageDigest.getInstance("SHA-256").digest(gbkHashInput);
            System.out.println("GBK Decoded Hash: " + bytesToHex(gbkDigest));
        } catch (Exception e) {
            System.out.println("GBK decoding failed or produced different string.");
        }

        System.out.println("UTF-8 Decoded Hash: " + bytesToHex(utf8Digest));
    }

    private static String bytesToHex(byte[] bytes) {
        StringBuilder sb = new StringBuilder();
        for (byte b : bytes) {
            sb.append(String.format("%02x", b));
        }
        return sb.toString();
    }
}
运行此代码可观察到,即使原始字节相同,因解码编码组合不同,哈希值也会变化。这验证了编码一致性在哈希校验中的必要性。若文件来源不明,建议优先使用 UTF-8,并在协议层明确声明编码类型。
当文件包含非法 UTF-8 序列时程序如何处理
若文件包含不符合 UTF-8 规范的字节序列,Java 在解码时会抛出 MalformedInputException 或替换为占位符。默认情况下,CharsetDecoder 会丢弃无效输入并记录错误,但 new String(bytes, charset) 简化版可能静默替换为 U+FFFD 字符。这会导致哈希值与预期不符,因为替换字符参与了计算。为避免此问题,应使用 CharsetDecoder 显式配置替换行为,或在预处理阶段过滤/修复非法字节。例如,设置 CodingErrorAction.REPLACE 可确保所有非法序列被统一替换,从而保证哈希的可重复性。若需严格校验,应在解码阶段捕获异常并终止流程,而非继续计算哈希。



















