








java 中使用 collator 处理本地化排序,核心是实例化一个与目标语言环境匹配的 collator 对象,并将其作为比较器传入集合的 sort() 方法。具体做法是先调用 collator.getinstance(locale) 获取实例,设置强度属性(如 primary、secondary 或 identical)以决定重音和大小写的敏感度,然后直接对字符串列表进行排序。这样做能确保中文按拼音、法语按重音等符合当地习惯的顺序排列,而非简单的 unicode 码点顺序。

如何配置 Collator 以忽略大小写但保留重音差异?
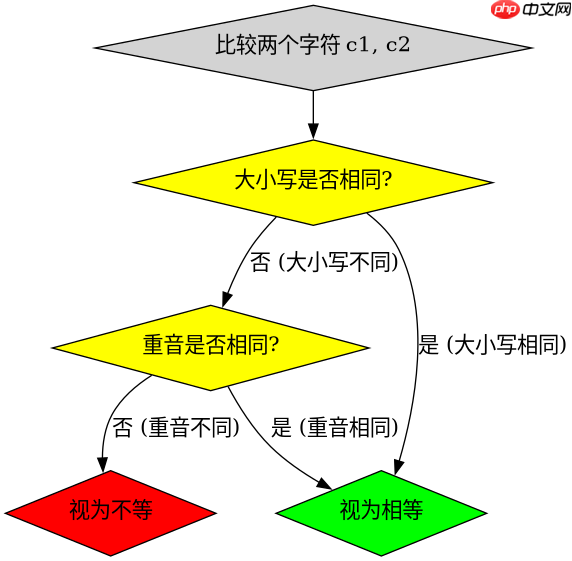
要忽略大小写但保留重音差异,需将 Collator 的强度设置为 SECONDARY。在此强度下,比较器会忽略大小写差异(视为相同),但会区分带有不同重音符号的字符(视为不同)。例如,在法语环境中,"cafe" 和 "café" 会被视为不同的元素并正确排序,而 "Apple" 和 "apple" 则被视为相同。
import java.text.Collator;
import java.util.Arrays;
import java.util.Collections;
import java.util.List;
import java.util.Locale;

public class SecondarySortExample {
    public static void main(String[] args) {
        // 创建法语环境的 Collator
        Collator collator = Collator.getInstance(Locale.FRENCH);
        // 设置强度为 SECONDARY:忽略大小写,区分重音
        collator.setStrength(Collator.SECONDARY);

        List<String> words = Arrays.asList("cafe", "Cafe", "café", "CAFÉ");
        System.out.println("原始: " + words);

        // 使用 Collator 排序
        Collections.sort(words, collator);

        System.out.println("排序后: " + words);
        // 预期输出: [cafe, Cafe, café, CAFÉ] (cafe/Cafe 在一起,café/CAFé 在一起,且前者排在后者前)
    }
}
如何实现完全忽略重音和大小写的纯字母排序?
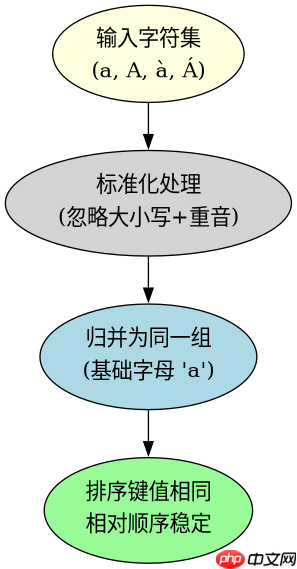
若需完全忽略重音和大小写,仅按基础字母排序,应将 Collator 强度设置为 PRIMARY。此设置下,"a"、"A"、"à"、"Á" 均被视为相等。这在需要模糊搜索或简单字典序的场景中非常有用。注意,对于中文,PRIMARY 强度通常按拼音首字母或完整拼音排序,具体取决于 JRE 的 ICU 库实现。

立即学习“Java免费学习笔记(深入)”;
import java.text.Collator;
import java.util.Arrays;
import java.util.Collections;
import java.util.List;
import java.util.Locale;

public class PrimarySortExample {
    public static void main(String[] args) {
        // 创建英语环境的 Collator
        Collator collator = Collator.getInstance(Locale.ENGLISH);
        // 设置强度为 PRIMARY:忽略大小写和重音
        collator.setStrength(Collator.PRIMARY);

        List<String> words = Arrays.asList("Zebra", "zebra", "Zébra", "zébra");
        System.out.println("原始: " + words);

        Collections.sort(words, collator);

        System.out.println("排序后: " + words);
        // 预期输出: [Zebra, zebra, Zébra, zébra] (所有变体视为相等,保持相对稳定性或按内部实现)
    }
}
当输入包含中文字符时,Collator 的默认排序行为是什么?
当输入包含中文字符时,Collator 默认会根据当前 Locale 的中文规则进行排序。如果 Locale 是 Locale.CHINA 或 Locale.SIMPLIFIED_CHINESE,排序通常基于汉语拼音。如果未指定特定中文 Locale 而使用默认 Locale,行为可能依赖于系统环境。对于非中文 Locale(如 Locale.US),中文可能按 Unicode 码点排序,这通常不符合用户期望。因此,处理中文时应显式指定中文 Locale。

















