








java中利用bytebuffer处理二进制数据的核心在于通过put和get系列方法按字节序读写基本类型。开发者只需实例化一个bytebuffer,调用如putint()或putfloat()等方法将数据写入缓冲区,随后即可通过对应的get方法读取并还原为原始数据类型。这种机制确保了内存中的二进制表示与java对象之间的无缝转换。

ByteBuffer如何存储整数和浮点数
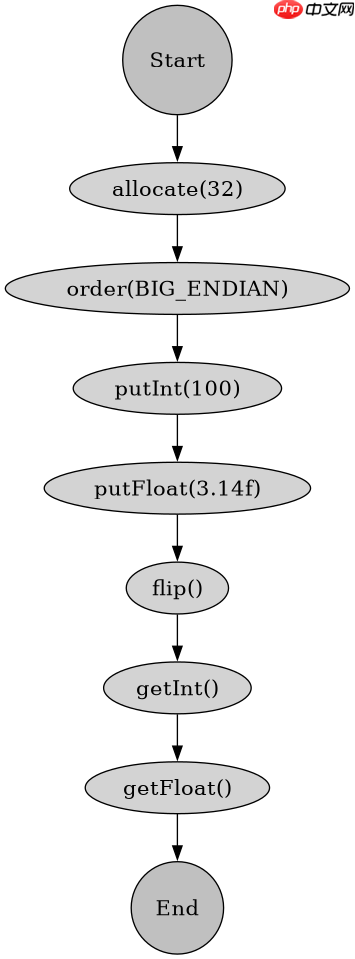
在ByteBuffer中存储整数和浮点数时,必须明确指定字节顺序(Byte Order),因为不同的架构对多字节数据的存储方式不同。默认情况下,ByteBuffer使用大端序(Big-Endian),即高位字节存储在低地址。通过调用putInt()可以将一个int类型的值转换为4个字节存入缓冲区,而putFloat()则遵循IEEE 754标准将浮点数转换为4个字节。读取时,getInt()和getFloat()会按照当前的字节序将这些字节重新组合成相应的数值。
import java.nio.ByteBuffer;
import java.nio.ByteOrder;

public class ByteBufferExample {
    public static void main(String[] args) {
        // 创建容量为32字节的堆缓冲区
        ByteBuffer buffer = ByteBuffer.allocate(32);

        // 设置字节序为大端(默认)
        buffer.order(ByteOrder.BIG_ENDIAN);

        // 写入整数和浮点数
        int intValue = 100;
        float floatValue = 3.14f;

        buffer.putInt(intValue);
        buffer.putFloat(floatValue);

        // 翻转缓冲区以便读取
        buffer.flip();

        // 读取数据
        if (buffer.hasRemaining()) {
            int readInt = buffer.getInt();
            float readFloat = buffer.getFloat();

            System.out.println("Read Int: " + readInt);
            System.out.println("Read Float: " + readFloat);
        }
    }
}
上述代码展示了完整的写入和读取流程。首先分配缓冲区,然后依次写入int和float。由于int占4字节,float也占4字节,总共写入8字节。调用flip()后,位置指针重置到0,限制指针设为当前写入的末尾,此时可以从头开始读取。读取出的readInt应为100,readFloat应为3.14。如果未正确调用flip(),读取操作可能会失败或返回错误数据,因为位置指针仍指向写入结束的位置。
立即学习“Java免费学习笔记(深入)”;

ByteBuffer如何处理字符串编码
处理字符串时,ByteBuffer本身不直接支持字符类型,需要先将字符串编码为字节数组,再放入缓冲区。通常使用UTF-8编码,因为它兼容ASCII且高效。通过StandardCharsets.UTF_8获取编码器,将String转换为byte[],然后使用put(byte[])方法将字节数组写入缓冲区。读取时,需先获取缓冲区的剩余字节,构造新的String对象,指定相同的字符集进行解码。这种方式确保了文本数据在二进制传输过程中的完整性。

import java.nio.ByteBuffer;
import java.nio.charset.StandardCharsets;

public class StringEncodingExample {
    public static void main(String[] args) {
        ByteBuffer buffer = ByteBuffer.allocate(64);

        String text = "Hello, World!";
        byte[] bytes = text.getBytes(StandardCharsets.UTF_8);

        // 写入字符串的字节表示
        buffer.put(bytes);

        // 翻转以读取
        buffer.flip();

        // 读取字节并还原字符串
        if (buffer.hasRemaining()) {
            byte[] readBytes = new byte[buffer.remaining()];
            buffer.get(readBytes);
            String readText = new String(readBytes, StandardCharsets.UTF_8);

            System.out.println("Read Text: " + readText);
        }
    }
}
该示例演示了字符串的二进制化处理。首先将"Hello, World!"转换为UTF-8字节数组,长度为13字节。这些字节被写入ByteBuffer。读取时,通过buffer.remaining()确定剩余字节数,创建一个等长的byte[]数组,并使用get()方法将缓冲区中的数据复制到该数组。最后,使用相同的StandardCharsets.UTF_8将字节数组还原为字符串。这种方法避免了直接使用String类可能带来的编码不一致问题,适用于网络通信或文件存储等场景。
当ByteBuffer容量不足时会发生什么
当尝试写入的数据超过ByteBuffer的剩余容量时,会抛出BufferOverflowException异常。这通常发生在未正确计算所需空间或未动态调整缓冲区大小的情况下。例如,若缓冲区容量为10字节,而试图写入一个占用12字节的long类型数据,或者连续写入多个元素导致总长度超出初始分配大小,JVM会在写入操作开始时检查剩余空间,不足则立即中断并抛出异常。为避免此问题,应在写入前检查remaining()方法返回值,或预先分配足够大的缓冲区,必要时使用ByteBuffer.allocateDirect()或手动扩容逻辑。



















