








使用 addbatch() 和 executebatch() 方法可以显著优化批量数据插入性能。具体做法是:先关闭自动提交(setautocommit(false)),在循环中调用 preparedstatement 的 addbatch() 方法将 sql 语句加入批次,最后调用 executebatch() 一次性执行所有语句并返回结果数组,随后通过 commit() 提交事务。

如何配置 PreparedStatement 以支持批量操作
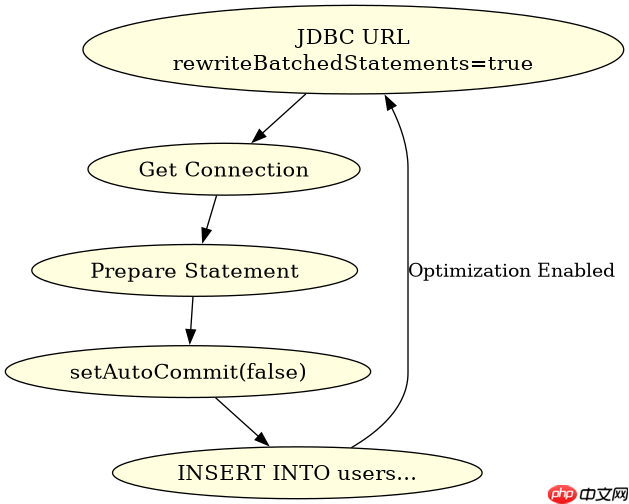
需要在创建连接时配置 URL 参数或在代码中设置属性,以确保 JDBC 驱动能正确处理批量指令。对于 MySQL,推荐在 JDBC URL 中添加 rewriteBatchedStatements=true 参数,这允许驱动将多个 INSERT 语句合并为一条多值 INSERT 语句发送,从而减少网络往返次数。同时,必须显式调用 connection.setAutoCommit(false) 来禁用自动提交,否则每次 addBatch() 后可能会立即执行或导致事务管理混乱。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;

public class BatchExample {
    public static void main(String[] args) throws Exception {
        String url = "jdbc:mysql://localhost:3306/test?rewriteBatchedStatements=true";
        try (Connection conn = DriverManager.getConnection(url, "user", "pass");
             PreparedStatement pstmt = conn.prepareStatement("INSERT INTO users (name) VALUES (?)")) {

            conn.setAutoCommit(false);
            for (int i = 0; i < 1000; i++) {
                pstmt.setString(1, "User_" + i);
                pstmt.addBatch();
            }
            int[] results = pstmt.executeBatch();
            conn.commit();
            System.out.println("Inserted rows: " + results.length);
        }
    }
}
上述代码展示了标准的批量插入流程。首先获取连接并启用 rewriteBatchedStatements 优化。接着关闭自动提交,进入循环。在循环内部,设置参数并调用 addBatch()。循环结束后,调用 executeBatch() 执行所有累积的语句,该方法返回一个整型数组,表示每个语句影响的行数。最后调用 commit() 提交事务。如果未关闭自动提交,某些驱动可能在 executeBatch() 之前或之后隐式提交,导致行为不可预测。
立即学习“Java免费学习笔记(深入)”;

如何处理批量执行中的异常与回滚
当批量操作中某条语句失败时,executeBatch() 的行为取决于驱动实现和配置。通常,它会抛出 BatchUpdateException。为了安全起见,应在 try-catch 块中捕获该异常,并在 catch 块中调用 rollback() 撤销整个批次的更改。此外,可以使用 clearBatch() 方法在出错后清空当前批次,以便重新尝试或记录错误信息。不同数据库驱动对部分成功的处理策略不同,MySQL 默认在遇到错误时停止后续执行,而 PostgreSQL 可能继续执行剩余语句。

import java.sql.BatchUpdateException;
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;

public class SafeBatchExample {
    public static void main(String[] args) throws Exception {
        String url = "jdbc:mysql://localhost:3306/test?rewriteBatchedStatements=true";
        Connection conn = null;
        try {
            conn = DriverManager.getConnection(url, "user", "pass");
            conn.setAutoCommit(false);
            PreparedStatement pstmt = conn.prepareStatement("INSERT INTO users (name) VALUES (?)");

            try {
                for (int i = 0; i < 1000; i++) {
                    pstmt.setString(1, "User_" + i);
                    pstmt.addBatch();
                }
                pstmt.executeBatch();
                conn.commit();
            } catch (BatchUpdateException e) {
                conn.rollback();
                System.err.println("Batch failed, rolled back. Error: " + e.getMessage());
                // Optionally clear batch and retry or log
                pstmt.clearBatch();
            } finally {
                if (conn != null && !conn.getAutoCommit()) {
                    conn.rollback(); // Ensure rollback on any other error
                }
            }
        } finally {
            if (conn != null) conn.close();
        }
    }
}
此示例增加了异常处理逻辑。在 try 块内执行批量操作,若发生 BatchUpdateException,则捕获异常并调用 rollback() 回滚事务。这确保了数据的一致性。在 finally 块中,再次检查并回滚,以防其他未捕获异常导致事务挂起。这种模式适用于对数据完整性要求较高的场景。注意,clearBatch() 用于清除已添加但未执行的语句,避免重复执行。
批量大小对性能的影响及最佳实践
批量大小直接影响内存使用和数据库负载。过小的批次(如每次10条)会导致频繁的网络往返,降低吞吐量;过大的批次(如10万条)可能占用大量客户端内存,并可能导致数据库服务器超时或内存溢出。一般建议将批次大小设置在 500 到 2000 之间,具体需根据实际测试调整。可以通过监控 executeBatch() 的执行时间和返回的结果数组长度来评估效果。此外,定期提交小批次而非一次性提交超大批次,有助于平衡内存压力和事务日志增长。


















