








java jdbc 处理批量操作事务主从复制的核心在于关闭自动提交并手动管理事务边界,同时通过设置连接属性或路由策略解决主从延迟导致的读取不一致问题。具体做法是调用 connection.setautocommit(false) 开启事务,使用 addbatch() 和 executebatch() 执行批量写入,并在 commit() 成功后才进行后续逻辑。对于主从场景,需确保写操作严格落在主库,读操作可路由至从库,并通过 statement.return_generated_keys 获取生成的主键以维持数据一致性。

JDBC 批量插入的事务控制流程是怎样的
JDBC 批量插入的事务控制依赖于显式的 commit() 和 rollback() 调用。在默认自动提交模式下,每条 SQL 都会立即生效,无法保证批量操作的原子性。开发者需要先将 autoCommit 设为 false,构建批次后提交,若发生异常则回滚。这种机制确保了要么所有记录成功写入,要么全部撤销,防止出现部分写入导致的数据脏乱。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;

public class BatchTransactionExample {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/mydb";
        String user = "root";
        String password = "password";

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            // 1. 关闭自动提交,开启事务
            conn.setAutoCommit(false);

            String sql = "INSERT INTO users (name, email) VALUES (?, ?)";
            try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
                for (int i = 0; i < 100; i++) {
                    pstmt.setString(1, "User_" + i);
                    pstmt.setString(2, "user_" + i + "@example.com");
                    pstmt.addBatch();
                }
                // 2. 执行批量操作
                int[] results = pstmt.executeBatch();
                // 3. 提交事务
                conn.commit();
                System.out.println("Batch insert completed. Rows affected: " + results.length);
            } catch (Exception e) {
                // 4. 异常时回滚
                conn.rollback();
                e.printStackTrace();
            }
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
上述代码展示了标准的批量事务处理流程。首先通过 setAutoCommit(false) 锁定事务上下文。循环中调用 addBatch() 将 SQL 语句加入缓冲区,而非立即发送。调用 executeBatch() 时,驱动会将累积的语句一次性发送给数据库,显著减少网络往返次数。如果过程中抛出 SQLException,程序进入 catch 块执行 rollback(),确保数据库状态恢复到事务开始前。注意 try-with-resources 会自动关闭资源,但不会自动提交或回滚事务,必须显式处理。
立即学习“Java免费学习笔记(深入)”;

如何配置 JDBC 连接以适配主从复制架构
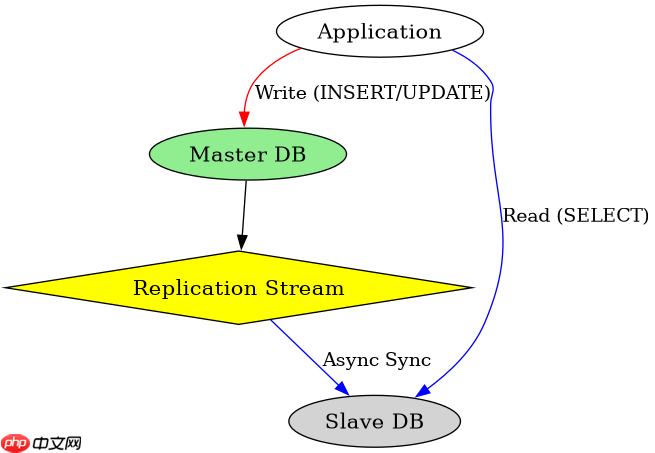
在主从复制架构中,JDBC 连接配置的关键是将写请求导向主库,读请求导向从库,并处理主从延迟。通常通过应用层的路由逻辑或中间件实现,但在纯 JDBC 层面,可以通过不同的 URL 和参数区分主从连接。对于写操作,必须使用指向主库的连接字符串;对于读操作,可使用指向从库的连接。此外,设置 useServerPrepStmts=true 和 rewriteBatchedStatements=true 可以优化批量性能,但需注意与事务的配合。

import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.ResultSet;
import java.sql.Statement;

public class MasterSlaveRouting {
    private static final String MASTER_URL = "jdbc:mysql://master-host:3306/mydb";
    private static final String SLAVE_URL = "jdbc:mysql://slave-host:3306/mydb";
    private static final String USER = "root";
    private static final String PASS = "password";

    public static void writeData() throws Exception {
        // 写操作:强制使用主库连接
        try (Connection masterConn = DriverManager.getConnection(MASTER_URL, USER, PASS)) {
            masterConn.setAutoCommit(false);
            String sql = "INSERT INTO logs (action) VALUES (?)";
            try (PreparedStatement pstmt = masterConn.prepareStatement(sql)) {
                pstmt.setString(1, "LOGIN");
                pstmt.executeUpdate();
                masterConn.commit();
            }
        }
    }

    public static void readData() throws Exception {
        // 读操作:使用从库连接
        try (Connection slaveConn = DriverManager.getConnection(SLAVE_URL, USER, PASS)) {
            Statement stmt = slaveConn.createStatement();
            ResultSet rs = stmt.executeQuery("SELECT * FROM logs WHERE action='LOGIN' LIMIT 1");
            if (rs.next()) {
                System.out.println("Read from slave: " + rs.getString("action"));
            }
        }
    }
}该示例演示了如何在代码层面区分主从连接。writeData 方法明确使用 MASTER_URL 建立连接,确保数据写入主节点,符合主从复制的写规则。readData 方法使用 SLAVE_URL,将负载分担到从节点。在实际生产中,这通常由连接池(如 HikariCP)的多数据源配置或代理(如 MyCat、ShardingSphere)完成。JDBC 本身不感知主从拓扑,因此开发者必须在业务逻辑中决定使用哪个连接。需要注意的是,刚写入主库的数据可能尚未同步到从库,此时立即查询从库可能返回空结果,即主从延迟问题。解决方案包括在关键业务中强制读主,或设置合理的重试机制。
批量插入后如何获取自增主键以用于后续从库查询
批量插入后获取自增主键是主从架构下常见的需求,因为后续操作可能需要这些 ID。JDBC 提供了 Statement.RETURN_GENERATED_KEYS 标志来实现这一点。在执行批量插入时,指定此标志,驱动会在执行后尝试从数据库获取生成的键。对于 MySQL,这通常通过 LAST_INSERT_ID() 或遍历结果集实现。获取到的键存储在 ResultSet 中,开发者可以遍历它来收集所有生成的 ID,从而在本地缓存或传递给其他服务,避免依赖从库查询可能带来的延迟风险。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.ResultSet;
import java.util.ArrayList;
import java.util.List;

public class BatchInsertWithKeys {
    public static void main(String[] args) throws Exception {
        String url = "jdbc:mysql://localhost:3306/mydb";
        String user = "root";
        String password = "password";

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            conn.setAutoCommit(false);
            String sql = "INSERT INTO products (name) VALUES (?)";

            // 关键:传入 RETURN_GENERATED_KEYS
            try (PreparedStatement pstmt = conn.prepareStatement(sql, PreparedStatement.RETURN_GENERATED_KEYS)) {
                for (int i = 0; i < 10; i++) {
                    pstmt.setString(1, "Product_" + i);
                    pstmt.addBatch();
                }
                pstmt.executeBatch();
                conn.commit();

                // 获取生成的键
                try (ResultSet keys = pstmt.getGeneratedKeys()) {
                    List<Long> ids = new ArrayList<>();
                    while (keys.next()) {
                        ids.add(keys.getLong(1));
                    }
                    System.out.println("Generated IDs: " + ids);
                }
            }
        }
    }
}
这段代码展示了如何在批量插入后提取自增 ID。通过在 prepareStatement 中传入 PreparedStatement.RETURN_GENERATED_KEYS,告诉驱动需要返回生成的键。执行 executeBatch() 后,调用 pstmt.getGeneratedKeys() 获取一个 ResultSet。遍历该结果集即可得到所有插入行的自增值。这对于需要在内存中维护 ID 映射或向其他系统推送变更的场景非常有用,因为它不依赖从库的同步状态,保证了数据的即时可用性。需要注意的是,不同数据库驱动对批量插入返回生成键的支持程度不同,MySQL Connector/J 支持良好,而某些旧版本或特定配置下可能需要额外检查。


















