








在java项目中利用日志工单系统跟踪问题,核心做法是将应用产生的结构化日志(如json格式)通过filebeat或logstash等采集器实时推送到elasticsearch集群,随后在kibana中配置dashboard并设置alerting规则。当监控到特定错误级别日志或业务指标异常时,系统自动触发webhook调用jira api创建工单,并将日志中的traceid、errorstack和关键参数作为附件或描述字段填入,从而实现从日志发现到问题追踪的自动化闭环。

如何配置日志采集与索引策略
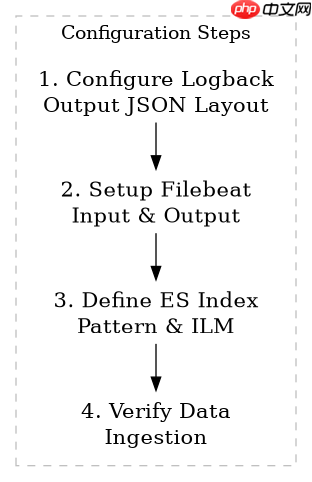
要实现有效的日志跟踪,首先需要确保日志数据能够被正确采集并存储。通常使用ELK栈(Elasticsearch, Logstash, Kibana)或EFK栈(Fluentd替代Logstash)。对于Java应用,推荐使用Logback或Log4j2输出JSON格式的日志,以便后续解析。采集端可以使用Filebeat轻量级地收集日志文件,将其发送至Logstash进行过滤和增强,或者直连Elasticsearch。在Elasticsearch中,建议按天或按周创建索引,并利用Index Lifecycle Management (ILM) 管理数据生命周期,避免磁盘空间耗尽。
{
  "app_name": "order-service",
  "level": "ERROR",
  "timestamp": "2023-10-27T10:00:00Z",
  "trace_id": "abc-123-def",
  "message": "Payment gateway timeout",
  "stack_trace": "java.net.SocketTimeoutException..."
}
上述JSON示例展示了标准日志结构。在实际配置中,需要在logback-spring.xml中定义JSON布局,并在Filebeat配置文件中指定日志路径和输出目标。例如,Filebeat可以配置为只发送包含“ERROR”或“FATAL”级别的日志到特定的Elasticsearch Index Pattern,从而减少噪音数据。
立即学习“Java免费学习笔记(深入)”;

如何设置基于日志的告警规则
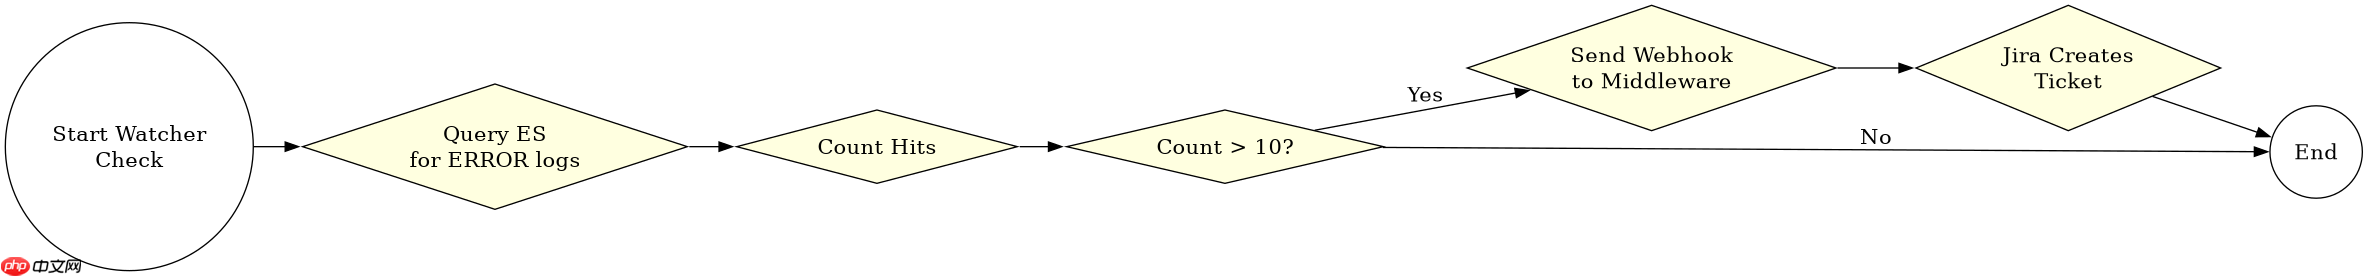
告警规则是连接日志系统与工单系统的桥梁。在Kibana中,可以通过Watchers或Alerts功能定义触发条件。常见的触发条件包括:特定关键字出现频率超过阈值、错误日志数量在单位时间内激增、或自定义脚本检测业务逻辑异常。一旦条件满足,Action部分配置为调用外部Webhook。这个Webhook地址应指向一个中间件服务或直接对接工单系统的API接口。
PUT /_watcher/watch/log_error_alert
{
  "trigger": {
    "schedule": { "interval": "5m" }
  },
  "input": {
    "search": {
      "request": {
        "indices": ["logs-*"],
        "body": {
          "query": {
            "bool": {
              "must": [
                { "term": { "level": "ERROR" } },
                { "range": { "@timestamp": { "gte": "now-5m" } } }
              ]
            }
          }
        }
      }
    }
  },
  "condition": {
    "compare": { "ctx.payload.hits.total": { "gt": 10 } }
  },
  "actions": {
    "create_jira_ticket": {
      "webhook": {
        "method": "POST",
        "url": "http://middleware:8080/api/jira/create",
        "body": "{{ctx.payload}}"
      }
    }
  }
}
该Watcher配置每5分钟检查一次过去5分钟内的ERROR日志数量。如果总数超过10条,则触发Webhook请求。中间件服务接收到请求后,会解析Payload,提取关键的trace_id和错误信息,然后构造HTTP POST请求发送给Jira的Create Issue API。这种方式确保了只有真正需要关注的异常才会生成工单,避免了告警风暴。
工单中如何关联具体日志上下文
当工单被创建后,开发人员需要能够快速定位到原始日志。最佳实践是在工单描述中嵌入直接链接到Kibana搜索结果的URL,并将trace_id作为工单的自定义字段。这样,开发者点击链接即可跳转到预置了过滤条件的Kibana视图,看到该次请求的所有相关日志。此外,可以在Java代码中使用MDC(Mapped Diagnostic Context)将trace_id注入到每个日志条目中,确保全链路追踪的完整性。
// Java MDC usage example
import org.slf4j.MDC;

public class TraceFilter implements Filter {
    public void doFilter(ServletRequest req, ServletResponse res, FilterChain chain) {
        String traceId = UUID.randomUUID().toString();
        MDC.put("trace_id", traceId);
        try {
            chain.doFilter(req, res);
        } finally {
            MDC.clear();
        }
    }
}
通过这种机制,每个请求都拥有唯一的标识符。当工单系统中提到某个trace_id时,运维或开发团队可以直接在日志平台搜索该ID,瞬间还原整个请求的处理过程,包括入参、出参、数据库操作及第三方调用结果。这不仅提高了排查效率,也确保了问题记录的准确性和可追溯性。



















