








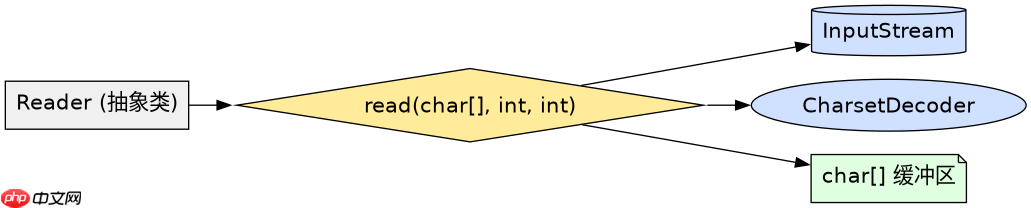
java 中实现自定义 reader 的核心方式是继承 java.io.reader 抽象类,并实现其核心的 read(char[], int, int) 方法。通过重载这个底层读取逻辑,你可以将字节流、网络数据或内存字符串转换为字符流供上层使用。这样做的好处是复用 java io 体系的标准接口,让其他标准组件(如 bufferedreader)能无缝处理你的自定义数据源。
如何基于 InputStream 封装一个自定义 Reader
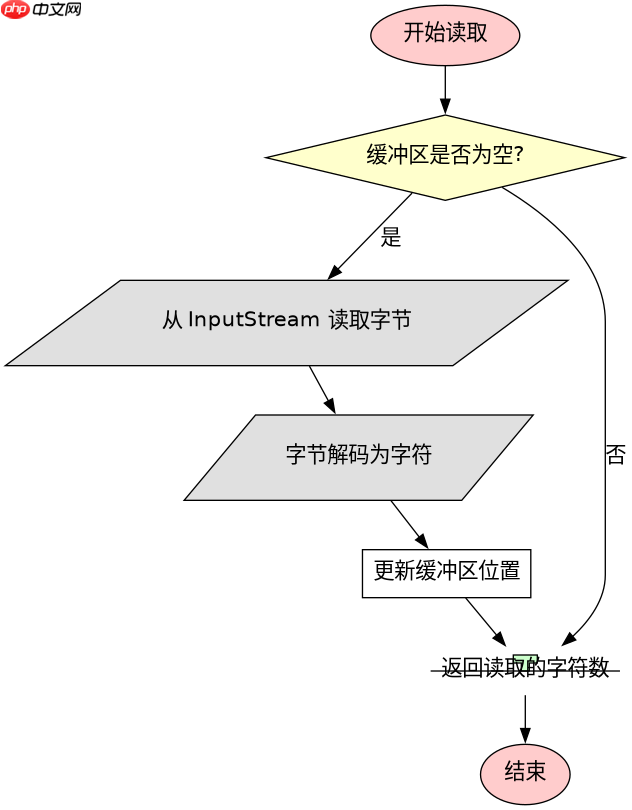
最典型的场景是将底层的 InputStream 包装为 Reader,这通常涉及编码转换。直接继承 Reader 并重写 read 系列方法即可实现。你需要在内部维护一个缓冲区,当缓冲区为空时从 InputStream 读取原始字节,并使用 CharsetDecoder 将其解码为字符数组返回给调用者。
import java.io.*;
import java.nio.charset.Charset;
import java.nio.charset.CharsetDecoder;

public class CustomStreamReader extends Reader {
    private final InputStream inputStream;
    private final CharsetDecoder decoder;
    private final char[] buffer = new char[1024];
    private int pos = 0;
    private int count = 0;

    public CustomStreamReader(InputStream in, Charset charset) {
        this.inputStream = in;
        this.decoder = charset.newDecoder();
    }

    @Override
    public int read(char[] cbuf, int off, int len) throws IOException {
        if (pos >= count) {
            // 重置缓冲区指针
            pos = 0;
            // 读取字节到临时缓冲区
            byte[] bytes = new byte[1024];
            int bytesRead = inputStream.read(bytes);
            if (bytesRead == -1) return -1;

            // 将字节解码为字符
            IntBuffer ib = IntBuffer.allocate(1024);
            CoderResult cr = decoder.decode(ByteBuffer.wrap(bytes, 0, bytesRead), ib, true);
            if (cr.isError() || cr.isOverflow()) throw new IOException("Decoding error");

            // 将 IntBuffer 中的 Unicode 码点转为 char 数组
            int[] codes = ib.array();
            int charsWritten = 0;
            for (int code : codes) {
                if (code > 0) {
                    Character.toChars(code, buffer, charsWritten++);
                } else break;
            }
            count = charsWritten;
        }

        if (count == 0) return -1;

        int charsToRead = Math.min(len, count - pos);
        System.arraycopy(buffer, pos, cbuf, off, charsToRead);
        pos += charsToRead;
        return charsToRead;
    }

    @Override
    public void close() throws IOException {
        inputStream.close();
    }
}
上述代码展示了完整的实现细节。关键点在于 read(char[], int, int) 方法的实现:它负责填充传入的字符数组。如果内部缓冲区没有数据,它会触发从底层 InputStream 读取字节并进行解码。这种设计确保了即使面对大文件,也能通过缓冲机制高效工作,而不会一次性将所有内容加载到内存中。
立即学习“Java免费学习笔记(深入)”;

如何实现基于 String 的自定义 Reader
另一种常见需求是从内存中的字符串或字节数组构建 Reader。这种情况下,不需要处理复杂的编码转换,只需管理字符索引即可。通过继承 Reader 并维护一个指向当前读取位置的整数变量,可以轻松实现只读的数据源。这种方式常用于单元测试或模拟数据输入。

import java.io.*;

public class StringReaderImpl extends Reader {
    private final char[] data;
    private int pos = 0;
    private int length;

    public StringReaderImpl(String str) {
        this.data = str.toCharArray();
        this.length = data.length;
    }

    @Override
    public int read(char[] cbuf, int off, int len) throws IOException {
        if (pos >= length) return -1;

        int charsAvailable = length - pos;
        int charsToRead = Math.min(len, charsAvailable);

        System.arraycopy(data, pos, cbuf, off, charsToRead);
        pos += charsToRead;
        return charsToRead;
    }

    @Override
    public void close() throws IOException {
        // 内存数据无需关闭
    }
}
该实现同样重写了 read(char[], int, int) 方法。与基于流的方式不同,这里直接从预分配的 char[] 中复制数据。由于不涉及 I/O 操作,性能极高且不会出现阻塞。在实际开发中,如果你只需要简单的字符串读取,直接使用 JDK 自带的 StringReader 即可,但理解其底层原理有助于你处理更复杂的自定义数据源。
未实现 read() 单字符方法会有什么影响
在继承 Reader 时,虽然必须实现 read(char[], int, int),但 Reader 类本身提供了一个默认的 read() 单字符实现。这个默认实现会调用 read(char[], int, int) 并将结果转换为单个字符。因此,如果你只实现了数组读取方法,单字符读取依然可以正常工作,只是效率稍低,因为每次调用都会创建新的数组对象或进行额外的边界检查。然而,为了获得最佳性能和避免潜在的递归栈溢出风险,建议显式重写 read() 方法,或者确保你的 read(char[], int, int) 实现足够健壮。


















