








设置gc告警阈值的核心做法是结合jvm内置的日志参数与外部监控工具,通过解析gc日志中的关键指标(如停顿时间、频率、堆内存变化)来触发告警。具体而言,需要在启动时开启详细gc日志(使用-xx:+printgcdetails等参数),然后利用脚本或agent定期分析这些日志文件,当检测到full gc耗时超过设定值(例如200ms)或young gc频率异常升高时,向监控系统发送告警信号。

如何配置JVM以输出详细的GC日志
要获取用于分析的数据,必须在Java应用启动参数中启用GC日志记录功能。这主要通过添加-XX:+PrintGCDetails、-XX:+PrintGCDateStamps以及-XX:GCLogOutputFile参数来实现,从而将GC事件的时间戳、类型、前后堆内存状态等信息写入指定文件。
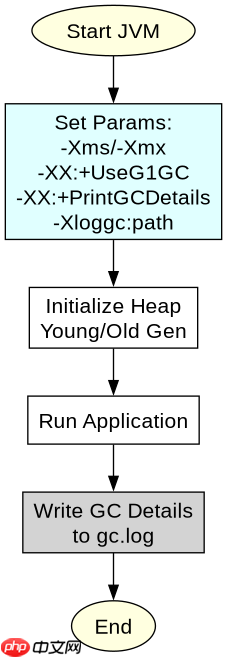
-Xms512m -Xmx512m
-XX:+UseG1GC
-XX:+PrintGCDetails
-XX:+PrintGCDateStamps
-Xloggc:/var/log/gc.log
-XX:+HeapDumpOnOutOfMemoryError
-XX:HeapDumpPath=/var/log/heapdump.hprof
上述配置适用于使用G1垃圾回收器的场景。其中-Xms和-Xmx设置了堆内存的初始值和最大值,确保内存空间稳定。-XX:+UseG1GC明确指定了G1收集器,这是现代Java应用推荐的选择。关键的日志参数包括-XX:+PrintGCDetails,它会在日志中打印每次GC的详细统计信息,如各代内存的使用情况;-XX:+PrintGCDateStamps则添加了时间戳,便于后续按时间序列分析。-Xloggc指向具体的日志文件路径,确保日志持久化存储。此外,-XX:+HeapDumpOnOutOfMemoryError会在发生OOM时自动生成堆转储文件,辅助深度排查。运行此配置后,应用启动时将生成gc.log文件,内容示例如下: [2023-10-27T10:00:00.000+0800]: [GC (Allocation Failure) [PSYoungGen: 102400K->0K(153600K)] 102400K->92160K(512000K), 0.0050000 secs]
如何基于GC日志数据计算并判断告警阈值
确定告警阈值需要关注两个核心维度:单次GC停顿时间和GC频率。通常,Young GC停顿时间应控制在毫秒级(如

立即学习“Java免费学习笔记(深入)”;
import java.io.BufferedReader;
import java.io.FileReader;
import java.util.regex.Matcher;
import java.util.regex.Pattern;

public class GcLogAnalyzer {
    public static void main(String[] args) throws Exception {
        String logFile = "/var/log/gc.log";
        double maxPauseTime = 0;
        int fullGcCount = 0;
        Pattern pattern = Pattern.compile("\[(.*?)\]: \[(GC|Full GC).*?\] ([^,]+) secs");

        try (BufferedReader br = new BufferedReader(new FileReader(logFile))) {
            String line;
            while ((line = br.readLine()) != null) {
                Matcher matcher = pattern.matcher(line);
                if (matcher.find()) {
                    String type = matcher.group(2);
                    double pauseTime = Double.parseDouble(matcher.group(3));
                    if (pauseTime > maxPauseTime) {
                        maxPauseTime = pauseTime;
                    }
                    if (type.equals("Full GC")) {
                        fullGcCount++;
                    }
                }
            }
        }
        System.out.println("Max Pause Time: " + maxPauseTime + "s");
        System.out.println("Full GC Count: " + fullGcCount);
    }
}
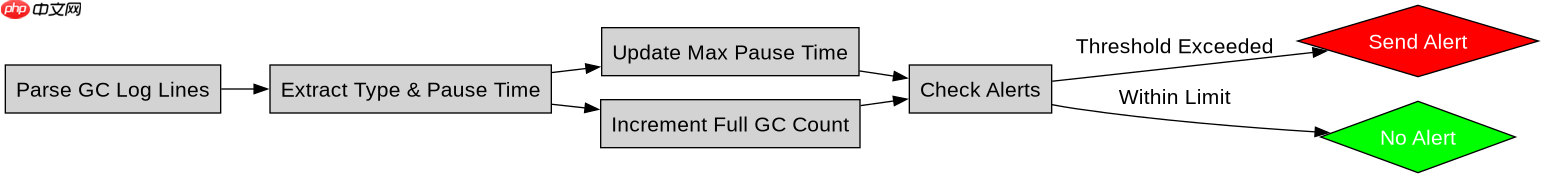
该Java程序演示了如何简单解析GC日志。它使用正则表达式匹配包含GC类型和停顿时间的行。对于每一行,提取GC类型(Young GC或Full GC)和停顿时间(秒)。程序遍历整个日志文件,更新最大停顿时间并统计Full GC的次数。在实际生产环境中,建议将此逻辑集成到Prometheus Exporter或自定义Agent中,实时推送指标。例如,可以设置当maxPauseTime超过0.2秒或fullGcCount在1小时内超过5次时,触发钉钉或邮件告警。这种基于实际日志数据的动态分析比静态配置更准确,能反映应用当前的真实负载状况。
当Full GC次数突然增加时说明了什么具体问题
Full GC次数突然增加通常意味着堆内存中存在大量无法被年轻代回收的对象,或者老年代空间不足导致触发紧急并发失败。这可能由内存泄漏、大对象直接分配进老年代、或GC线程CPU过载引起。此时应用会出现明显的停顿,响应变慢,甚至可能引发服务雪崩。


















