








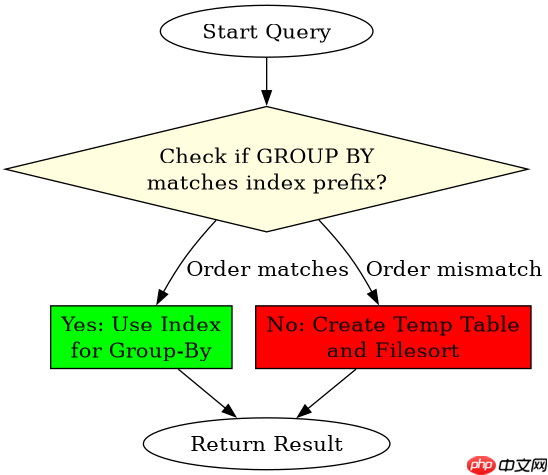
调整 group by 列的顺序会改变数据库优化器对数据分组逻辑的评估,进而影响执行计划中是否使用索引、选择何种排序算法以及内存消耗。核心原因在于大多数关系型数据库(如 mysql)依赖 b+ 树索引,而索引天然有序的特性使得特定顺序的分组可以直接利用索引避免额外的文件排序(filesort)。当 group by 的顺序与索引前缀顺序一致时,优化器可能选择 index 访问类型直接扫描索引完成分组;若顺序不一致或涉及多列,则往往需要引入临时表并进行内部排序,导致性能显著下降。

为什么 GROUP BY 顺序与索引前缀匹配能消除 Filesort
当 GROUP BY 的列顺序完全匹配索引的最左前缀时,数据库可以利用索引的有序性直接进行分组,无需额外排序。例如,在 (a, b) 索引上按 a, b 分组,数据在索引中已经是有序的,优化器会选择 Using index for group-by 策略,直接遍历索引即可得到分组结果,避免了创建临时表和文件排序的开销。反之,如果按 b, a 分组,由于索引在 b 列上无序,优化器必须使用临时表存储中间结果,并对 b 列进行排序,这会导致性能急剧下降。
CREATE TABLE test_group ( id INT PRIMARY KEY, a INT, b INT, c INT, INDEX idx_a_b (a, b) );

-- 场景 1: GROUP BY 顺序与索引前缀一致,利用索引有序性
SELECT a, b, COUNT(*) FROM test_group GROUP BY a, b;

-- 场景 2: GROUP BY 顺序与索引前缀不一致,触发文件排序
SELECT b, a, COUNT(*) FROM test_group GROUP BY b, a;
预期结果:场景 1 的执行计划显示 type: index 且 Extra: Using index for group-by,无临时表;场景 2 的执行计划显示 type: ALL 或 index,且 Extra: Using temporary; Using filesort,表明发生了文件排序。
不同数据库引擎对 GROUP BY 排序行为的差异处理
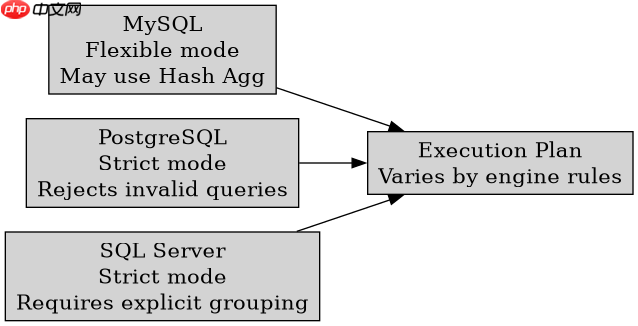
不同数据库引擎对 GROUP BY 的处理策略存在显著差异。MySQL 5.7 及更早版本默认启用 ONLY_FULL_GROUP_BY 模式,要求非聚合列必须在 GROUP BY 中出现,否则报错;而 PostgreSQL 和 SQL Server 则严格遵循 SQL 标准,不允许选择未在 GROUP BY 中出现的非聚合列。此外,MySQL 8.0 引入了更智能的优化器,可能在某些情况下即使 GROUP BY 顺序不匹配索引,也能通过哈希聚合(Hash Aggregation)替代传统排序,从而减少文件排序的影响。然而,对于大规模数据,哈希聚合仍可能占用较多内存,需根据实际数据量权衡。
-- MySQL 示例:检查当前 ONLY_FULL_GROUP_BY 状态
SELECT @@sql_mode LIKE '%ONLY_FULL_GROUP_BY%';

-- PostgreSQL 示例:尝试违反 GROUP BY 规则
SELECT a, b, COUNT(*) FROM test_group GROUP BY a;
-- 错误:column "test_group.b" must appear in the GROUP BY clause or be used in an aggregate function
预期结果:MySQL 查询返回布尔值 1 或 0,表示是否启用严格模式;PostgreSQL 查询抛出语法错误,提示列未出现在 GROUP BY 子句中。这表明不同数据库对 GROUP BY 的语义和执行约束存在本质差异,开发者需根据目标数据库调整查询写法。
当 GROUP BY 包含函数表达式时,执行计划如何变化
当 GROUP BY 中包含函数表达式(如 YEAR(date_col))时,优化器无法直接利用索引的有序性,因为索引存储的是原始值而非计算后的值。此时,数据库必须对每一行应用函数并生成临时结果,再进行分组。这通常会导致全表扫描和显式的文件排序,即使存在相关索引也无法加速。例如,在 (date_col) 索引上按 YEAR(date_col) 分组,优化器会忽略索引,转而使用临时表存储所有行的年份值,并对其进行排序。这种操作在数据量大时性能极差,建议通过添加虚拟列或物化视图来预计算函数值,以恢复索引的使用效率。


















