








在sql中对分组数据应用limit只取前三条记录,核心做法是使用窗口函数 row_number() 配合子查询或cte。具体步骤是先按目标列进行分组排序,生成行号,然后在外部查询中过滤出行号小于等于3的记录。这样做会得到每个分组内按指定顺序排列的前三条数据。若存在并列情况且希望全部保留,可改用 rank() 或 dense_rank(),但需注意这可能导致返回记录数超过3条。

使用ROW_NUMBER实现分组TopN
直接回答:使用 ROW_NUMBER() OVER (PARTITION BY ... ORDER BY ...) 可以精确获取每组前N条记录。关键在于分区(PARTITION BY)定义分组,排序(ORDER BY)定义“前”的标准。外部查询通过 WHERE rn 筛选结果。此方法保证每组最多返回3条,严格遵循数量限制。
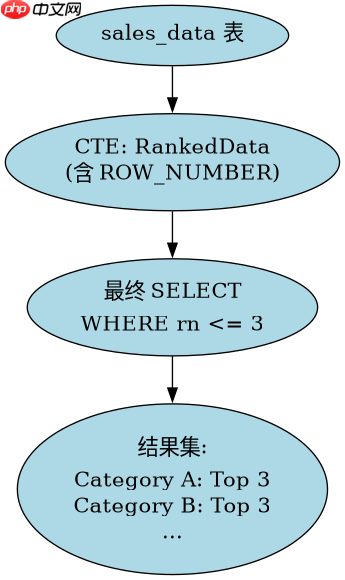
WITH RankedData AS (
    SELECT
        category,
        value,
        ROW_NUMBER() OVER (PARTITION BY category ORDER BY value DESC) as rn
    FROM sales_data
)
SELECT category, value
FROM RankedData
WHERE rn <= 3;
预期结果:假设 sales_data 表中有多个类别,每个类别有多条销售记录。上述查询将返回每个类别中 value 最高的前三条记录。如果某类别只有两条记录,则返回这两条。如果某类别有五条记录,则只返回最高的三条,其余被过滤。
处理并列排名的情况
直接回答:当需要保留并列名次的记录时,应使用 RANK() 或 DENSE_RANK() 替代 ROW_NUMBER()。RANK() 会在并列时跳过后续名次(如1,1,3),而 DENSE_RANK() 不会跳过(如1,1,2)。这会导致返回的记录数可能超过3条,因为同一组内可能有多个并列第3名的记录。
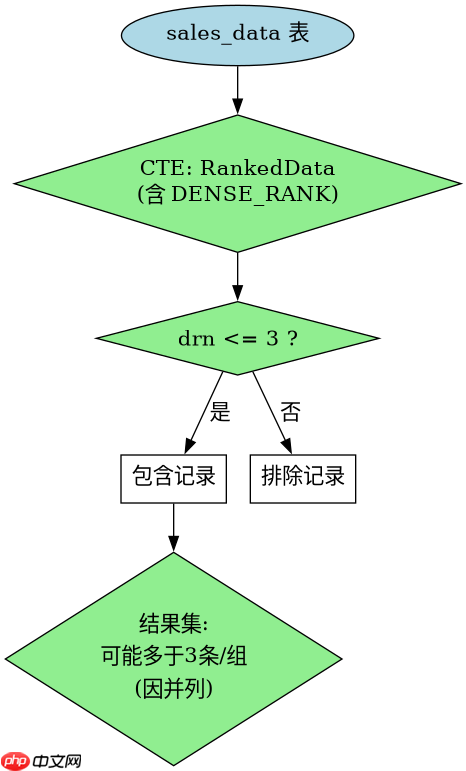
WITH RankedData AS (
    SELECT
        category,
        value,
        DENSE_RANK() OVER (PARTITION BY category ORDER BY value DESC) as drn
    FROM sales_data
)
SELECT category, value
FROM RankedData
WHERE drn <= 3;
预期结果:与上一个示例相同的数据源。使用 DENSE_RANK() 后,如果某个类别中有多个记录的 value 并列第三高,这些记录都会被返回。因此,该类别返回的记录数可能是3条或更多,取决于并列的数量。例如,如果有两个记录并列第三,则该类别返回4条记录(最高、次高、两个并列第三)。
基于特定输入条件的性能考量
直接回答:当数据量巨大时,窗口函数的性能可能成为瓶颈。优化策略包括确保 PARTITION BY 和 ORDER BY 的列上有合适的索引,或者在可能的情况下使用相关子查询或交叉应用(Cross Apply)来减少中间结果集的大小。对于极大规模数据,考虑分批次处理或使用数据库特定的TopN优化功能。


















