








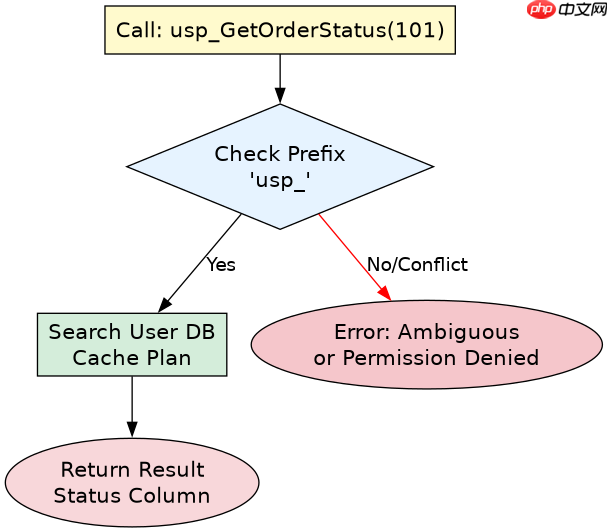
在sql存储过程中遵循最佳命名规范,核心做法是统一使用`sp_`前缀标识系统级或通用过程、`usp_`前缀标识用户自定义过程,并采用`动词_名词`的帕斯卡命名法(pascalcase)组合。这样做的结果是代码可读性极高,且能有效避免与sql server内置系统存储过程发生冲突。若未加前缀直接命名为`getuser`,则可能触发性能回退或权限检查异常,因此务必保持前缀一致。

如何区分系统存储过程与用户自定义存储过程
通过为自定义存储过程添加`usp_`前缀,可以明确将其与系统自带的`sp_`存储过程区分开来。这种命名策略不仅符合微软官方推荐的最佳实践,还能防止因名称重复导致的执行计划缓存污染。当开发者看到`usp_GetOrderStatus`时,能立即识别这是业务逻辑的一部分,而非数据库内核功能。
-- 创建用户自定义存储过程
CREATE PROCEDURE usp_GetOrderStatus
    @OrderId INT
AS
BEGIN
    SELECT Status FROM Orders WHERE Id = @OrderId;
END;
上述代码展示了标准的定义方式。执行该过程时,数据库引擎会优先搜索用户定义的`usp_`对象,从而绕过对系统目录中同名潜在冲突的检查。预期结果为成功返回订单状态,且执行计划针对用户逻辑优化。
参数命名应遵循什么规则以避免歧义
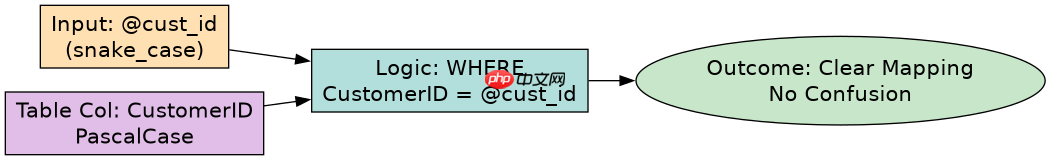
参数命名应采用小写前缀加下划线的蛇形命名法(snake_case),如`@input_date`或`@user_id`,以区别于变量和全局变量。这种规则确保了在过程内部引用参数时语义清晰,特别是当参数名与表列名相似时,能减少拼写错误带来的Bug。例如,使用`@cust_id`比`@id`更能明确其代表客户标识符。
-- 演示参数命名规范
CREATE PROCEDURE usp_UpdateCustomer
    @cust_id INT,
    @new_email NVARCHAR(100)
AS
BEGIN
    UPDATE Customers
    SET Email = @new_email
    WHERE CustomerID = @cust_id;
END;
在此示例中,`@cust_id`直接映射到`Customers`表的`CustomerID`列,但通过不同的命名风格避免了混淆。运行此过程时,需传入具体的整数ID和新邮箱字符串。预期结果是更新指定客户的邮箱地址,若输入无效类型则会抛出转换错误。
基于输入参数为空时的具体处理逻辑是什么
当输入参数如`@OrderId`为NULL时,程序应显式检查并返回特定状态或默认结果,而不是让查询静默失败。在`usp_GetOrderStatus`中,若传入NULL,应直接返回空集或错误码,因为主键不能为NULL。这种防御性编程习惯能确保调用方获得明确的反馈,便于前端或应用层进行错误处理。
-- 增强版:处理空输入
CREATE PROCEDURE usp_GetOrderStatusSafe
    @OrderId INT
AS
BEGIN
    IF @OrderId IS NULL
    BEGIN
        RAISERROR('Order ID cannot be null', 16, 1);
        RETURN;
    END
    SELECT Status FROM Orders WHERE Id = @OrderId;
END;
该代码段增加了对`NULL`的判断。当调用者传入NULL值时,系统将触发错误并终止执行。预期行为是捕获到“Order ID cannot be null”的错误信息,而非返回无数据的记录集。这验证了命名规范之外,逻辑健壮性同样依赖于对边界条件的显式处理。


















