








sensenova loop-9b可以按官方transformers示例加载完整模型目录,使用聊天模板构造输入,再从generate结果中切掉输入token并解码新增文本。以下为单gpu bf16加载路径,需要能容纳完整权重及运行开销的cuda环境;它没有启用4-bit量化,不能套用低显存表中约4.9gb权重的条件。
准备相容环境和完整模型文件
官方标注的已检查Preview环境为Transformers 5.18.0、PyTorch 2.11.0和CUDA 13.0。这是参考环境说明,不等于所有正式版引擎组合都已经验证。先按PyTorch安装指引选择与本机驱动相容的CUDA构建,再在独立Python虚拟环境安装其余依赖。
python3 -m venv .venv
source .venv/bin/activate
# 先安装与本机CUDA和驱动相容的PyTorch,再执行:
python -m pip install "transformers==5.18.0" accelerate safetensors
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
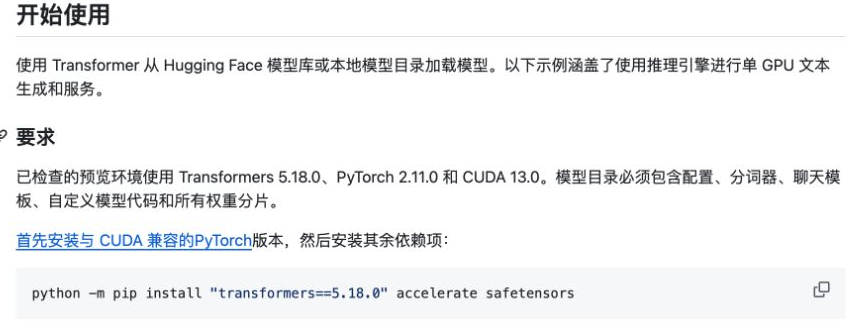
官方说明明确这些环境版本来自已检查的Preview环境。
从官方模型库取得配置、分词器、聊天模板、自定义模型代码和全部权重分片,放进同一目录。若模型库要求登录或接受访问条件,应先按页面要求完成。trust_remote_code=True会加载仓库附带的Python代码,只对已核对的官方版本使用,并在运行前检查相关文件。
生成并只打印新增文本
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "/path/to/SenseNova-Loop-9B"  # 改为实际完整模型目录
device = "cuda:0"
tokenizer = AutoTokenizer.from_pretrained(model_id, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    trust_remote_code=True,
    dtype=torch.bfloat16,
    device_map={"": device},
).eval()
messages = [{"role": "user", "content": "What is 13 times 7?"}]
prompt = tokenizer.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=True, enable_thinking=True
)
inputs = tokenizer(prompt, return_tensors="pt").to(device)
with torch.inference_mode():
    outputs = model.generate(
        **inputs, max_new_tokens=512, do_sample=False, use_cache=True
    )
new_tokens = outputs[0, inputs.input_ids.shape[1]:]
print(tokenizer.decode(new_tokens, skip_special_tokens=True))
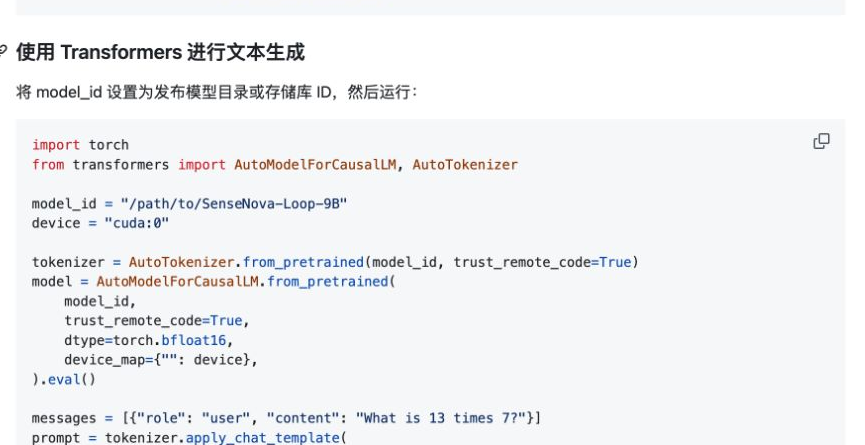
官方示例的模型加载部分;完整生成与输出处理见正文代码。
区分模板、输出预算和显存不足
enable_thinking=True由模型聊天模板处理;需要关闭时按官方模板把它设为False,不要仅从最终字符串中随意删除内容来模拟关闭。max_new_tokens=512限制新增Token数量,不是输入长度;回答被截断时,应结合任务需要调整预算与可用显存。
遇到自定义模型加载错误,先核对目录是否缺少模型代码或分片、Transformers版本是否相容;CUDA内存不足则检查权重精度、上下文长度和剩余显存。要采用AWQ或低精度KV缓存,应切换到相应权重与适配引擎配置,这份BF16脚本不会自动完成量化。
























