








sensenova loop-9b正式版的官方部署说明列出了一组低显存估算:在4-bit权重量化条件下,256k上下文搭配8-bit kv缓存约需15gib显存,搭配4-bit kv缓存约需12gib。文档同时给出约4.9gb的权重体积,这一数值只描述量化权重,不能直接当作运行长上下文时的全部显存需求。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
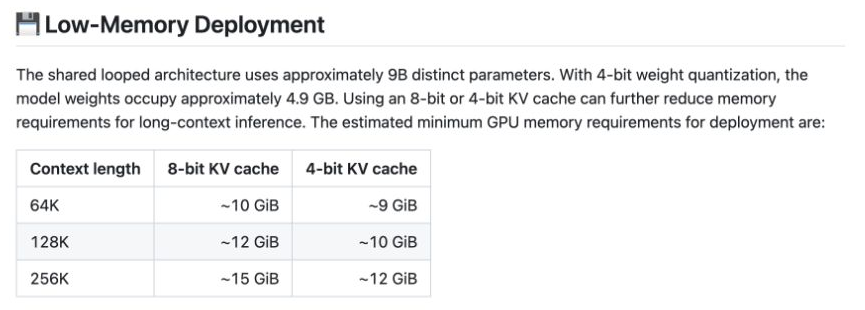
官方给出的估算表,分别列出上下文长度与KV缓存精度。
上下文与KV缓存精度决定额外开销
在同样采用4-bit权重的前提下,64K上下文对应8-bit、4-bit KV缓存的估算下限分别约为10GiB和9GiB;128K分别约为12GiB和10GiB;256K分别约为15GiB和12GiB。表格的两列改变的是KV缓存精度,不是把BF16权重与4-bit权重混在一起比较。
权重之外仍需容纳KV缓存、运行时工作区和其他开销,实际占用还受推理引擎、请求配置和输入内容影响。512K是模型标注的最大上下文范围,而这张显存表只列到256K,不能据此直接外推512K的部署要求。
量化部署与BF16示例走不同路径
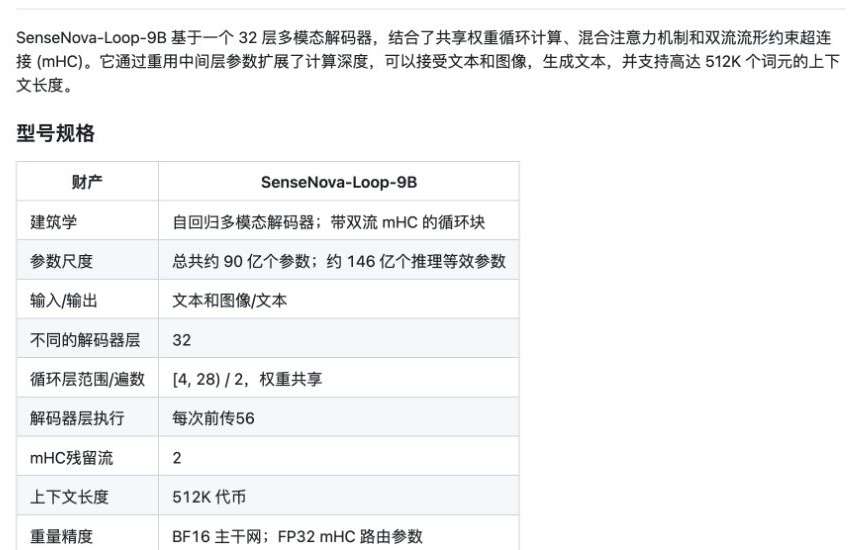
官方模型卡中的参数、层数、输入输出及上下文规格。
官方还宣布提供AWQ 4-bit版本。使用时需匹配具体量化权重、推理引擎及KV缓存支持;普通Transformers示例以BF16加载完整权重,并不会因为模型存在AWQ版本就自动变成表格中的低显存配置。
目前官方入门说明中的已检查环境来自Preview,SGLang和vLLM示例也注明了适配PR及正式版配置调整要求。准备本地部署时,除可用显存外,还需要确认对应模型代码、量化格式和引擎分支相容。
























