





商汤科技正式对外开源全新一代轻量级、原生统一多模态大模型——sensenova u1.5lite。该模型参数量为8b,定位轻量化部署场景,却在多项关键视觉任务中展现出优于同级别竞品的性能表现,甚至在复杂版式理解与高精度文字渲染等细分能力上,已接近主流超大规模商业模型的实际交付水准。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
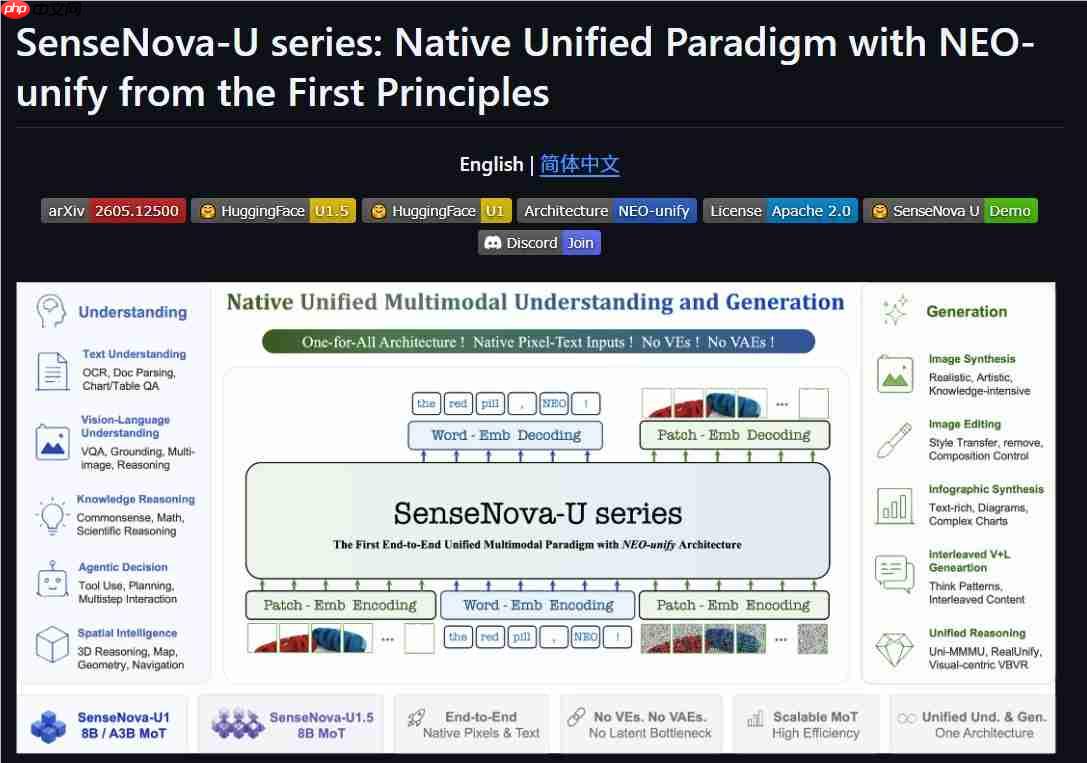
SenseNova U1.5Lite 原生支持3K至4K长度的上下文窗口,可同步建模主体对象、数量关系、空间方位、文本内容、页面布局及视觉风格等多重语义约束,从而大幅提升模型在高难度视觉任务中的推理稳定性与输出一致性。
在功能层面,本模型实现了多项关键突破:
第一,视觉生成质量全面跃升,显著优化构图逻辑、色彩协调性、材质质感、光影层次、画面真实感以及局部细节还原度,有效缓解传统多模态模型普遍存在的“局部合理、整体失衡”问题;
第二,原生图像编辑能力更加稳健,大幅增强对主体身份特征、三维空间结构、图文版式关系及未编辑区域内容的一致性保持,并在局部重绘、元素替换、文字精细化调整、跨参考图协同编辑等典型场景中实现综合性能升级。

将小说章节转换为电影分镜剧本。用户上传txt/md/docx文本,AI分析场景、角色、情绪、镜头语言,输出专业分镜脚本。适用于用户提及“分镜”“storyboard”“小说转分镜”“影视改编”“镜头脚本”或需要将小说改编为分镜的场景。
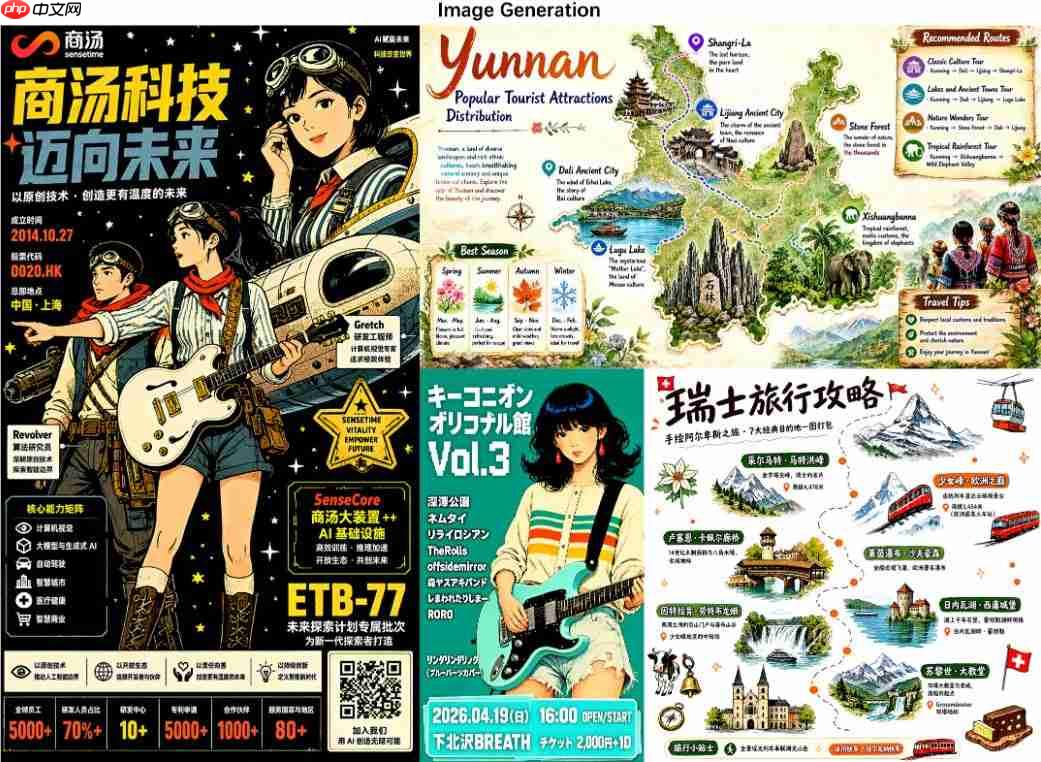
此外,在文字识别与复杂排版处理方面亦取得重要进展,全面强化中英文混合文本、海报设计、信息图表、品牌视觉规范及多段落多层级文本布局的理解与生成能力,推动AI生成内容向具备专业级视觉表达力的方向演进。在可控生成方面,模型原生支持边界框(Bounding Box)、视觉标记(Visual Marker)以及单图/多图参考等多种控制机制,实现对指定区域或对象的精准干预。尤为突出的是,其原生支持4K分辨率输出,在超高分辨率生成过程中仍能兼顾全局构图合理性与微观纹理、极小字号文字、精细光影折射等细节表现力。
项目地址:https://www.php.cn/link/7ec7b3c207af454ab8ef81ae3599e008













