








游戏服务器 cpu 选型的核心在于匹配业务负载特征。对于大多数传统游戏服务器,单线程逻辑模型仍占主导,因此应优先选择高主频、强单核性能的处理器,并严格控制每颗 cpu 承载的逻辑线程数,避免过多的上下文切换导致性能衰减。
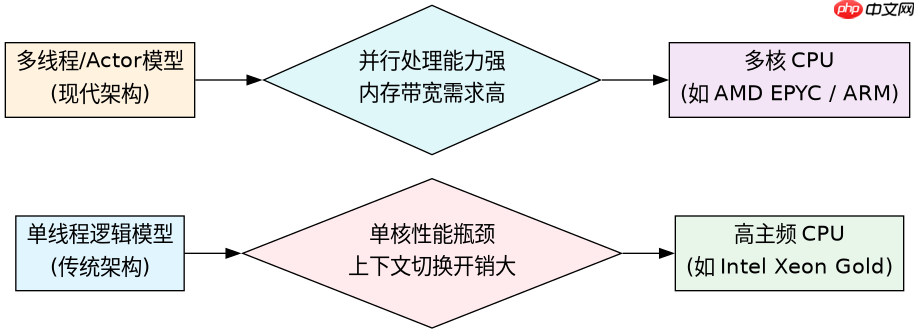
架构模式与核心数权衡
在确定具体型号前,必须明确服务器的架构模式。如果采用传统的单线程循环(Single-threaded Loop)或基于消息队列的轻量级多线程架构,CPU 的单核 IPC(每时钟周期指令数)和主频是决定性因素。这类架构下,增加核心数并不能直接提升吞吐量,反而可能因缓存一致性(Cache Coherence)开销降低整体效率。此时,Intel 至强(Xeon)系列中主打高频的型号往往更具优势。
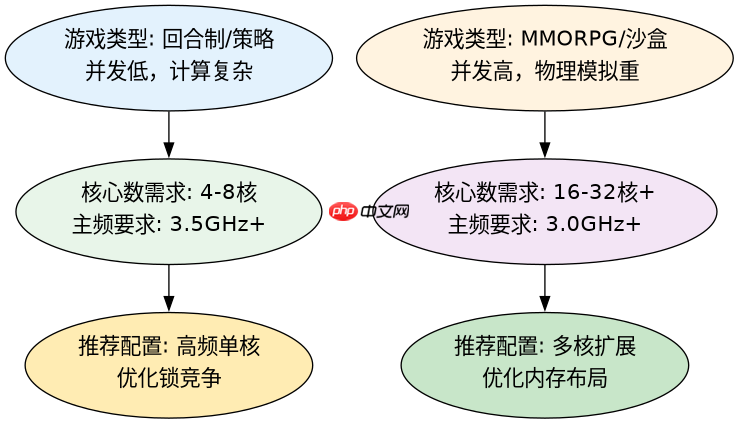
若采用 Actor 模型或分片(Sharding)架构,将不同玩家或场景的数据隔离到不同的线程或进程中,则多核 CPU 的价值得以体现。AMD EPYC 或 ARM 架构的多核处理器在此类场景下表现更佳,因为它们提供了更多的核心数量和更大的内存带宽,适合处理高并发下的数据并行计算。选型时需评估:如果业务能轻松拆分且通信开销低,多核是更经济的选择;若业务耦合度高,高频单核仍是首选。
多核负载均衡实现示例
以下代码展示了一个简单的多核负载均衡器,将任务分发到多个工作线程,每个线程绑定到特定的 CPU 核心,以减少跨核通信延迟。
#include <iostream>
#include <thread>
#include <vector>
#include <functional>
#include <atomic>

std::atomic<size_t> task_counter{0};
const size_t num_cores = 4;

void worker_thread(int core_id) {
    while (true) {
        size_t task_id = task_counter.fetch_add(1);
        if (task_id >= 100) break; // 假设总共100个任务
        std::cout << "Core " << core_id << " processing task " << task_id << std::endl;
        // 模拟计算
        volatile int sum = 0;
        for (int i = 0; i < 1000000; ++i) sum += i;
    }
}

int main() {
    std::vector<std::thread> threads;
    for (int i = 0; i < num_cores; ++i) {
        threads.emplace_back(worker_thread, i);
    }
    for (auto& t : threads) {
        t.join();
    }
    return 0;
}
该程序创建四个线程,分别处理任务队列中的任务。在实际部署中,建议通过操作系统工具(如 Linux 的 taskset 或 setaffinity)将线程绑定到特定核心,以利用 CPU 缓存局部性。预期结果是四个核心同时工作,总处理时间约为单线程的四分之一,但需关注原子操作的竞争开销。
NUMA 架构对内存访问的影响
在多路服务器(Multi-socket)中,NUMA(非统一内存访问)架构成为关键考量因素。当进程访问本地节点内存时,延迟远低于访问远程节点内存。游戏服务器通常维护大量状态数据,若内存分配跨越 NUMA 节点边界,将导致显著的性能下降。因此,在选型和部署时,应确保应用进程的内存分配与 CPU 核心位于同一 NUMA 节点,或通过内核参数调整内存分配策略,以最小化远程访问延迟。



















