








选择负载均衡算法的核心在于明确业务对请求分发的公平性、连接保持以及后端服务器负载能力的要求。对于大多数无状态且计算资源差异不大的web服务,轮询(round robin)是最基础且通用的选择;若需根据后端实际处理能力分配流量,则应配置加权轮询(weighted round robin);而对于长连接或会话敏感型应用,一致性哈希(consistent hashing)能显著降低缓存失效和会话丢失的风险。
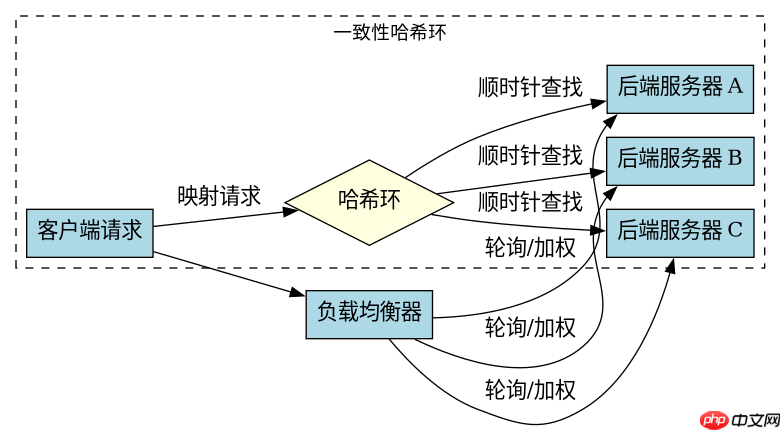
轮询与加权轮询在静态资源分发中的表现
当后端服务器性能一致且请求处理时间相近时,轮询算法能确保每个请求被均匀分配,实现最简单的负载均衡。如果服务器存在性能差异,例如部分节点配置更高,通过设置权重参数,可以让高配节点承担更多流量,从而优化整体资源利用率。
import random

class LoadBalancer:
    def __init__(self, servers):
        self.servers = servers
        self.total_weight = sum(s['weight'] for s in servers)
        self.current_index = 0

    def get_next_server_round_robin(self):
        if not self.servers:
            return None
        server = self.servers[self.current_index % len(self.servers)]
        self.current_index += 1
        return server

    def get_next_server_weighted(self):
        if not self.servers:
            return None
        rand_val = random.randint(1, self.total_weight)
        current_sum = 0
        for server in self.servers:
            current_sum += server['weight']
            if rand_val <= current_sum:
                return server
        return self.servers[-1]

servers = [
    {'name': 'Server_A', 'weight': 1},
    {'name': 'Server_B', 'weight': 3}
]

lb = LoadBalancer(servers)
print("RR Result:", lb.get_next_server_round_robin()['name'])
print("WRR Result:", lb.get_next_server_weighted()['name'])
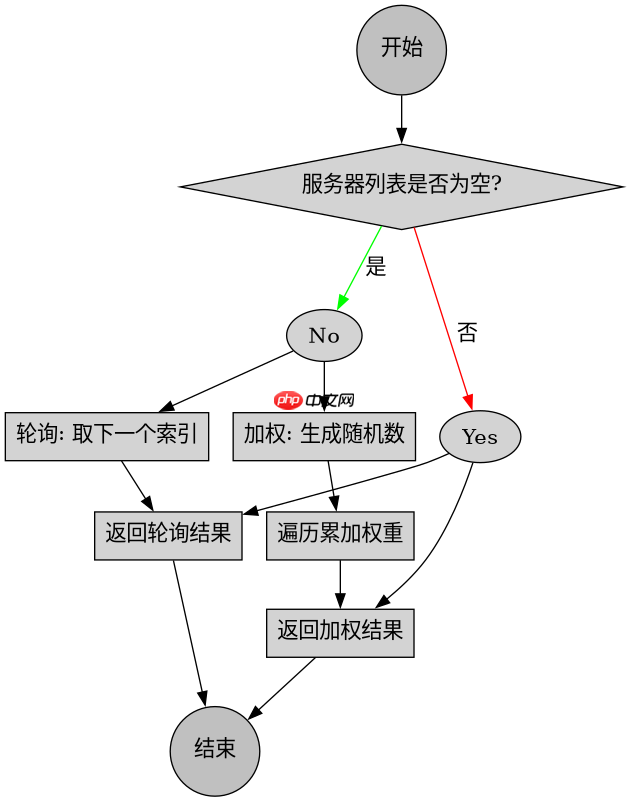
上述代码展示了两种算法的基本逻辑。在轮询模式下,请求按顺序依次分配给 Server_A 和 Server_B。而在加权模式下,由于 Server_B 的权重为 3,它在随机选取中出现的概率是 Server_A 的三倍。这种机制确保了高性能节点获得更多请求,同时低性能节点仍能分担少量流量,避免了过载。
一致性哈希在会话保持中的应用
在处理需要保持用户会话(Session)或本地缓存的应用时,简单的轮询会导致用户每次请求都被分发到不同后端,造成会话丢失或缓存命中率下降。一致性哈希算法通过将服务器和用户请求映射到同一个哈希环上,使得只有当服务器增减时,少量请求才会重新分布,从而极大地提高了会话的稳定性。

class ConsistentHash:
    def __init__(self, nodes=None):
        self.nodes = nodes or []
        self.hash_ring = {}
        self.sorted_keys = []
        if nodes:
            for node in nodes:
                self.add_node(node)

    def _hash(self, key):
        return hash(key) % (2**32 - 1)

    def add_node(self, node):
        self.nodes.append(node)
        key = self._hash(node)
        self.hash_ring[key] = node
        self.sorted_keys = sorted(self.hash_ring.keys())

    def remove_node(self, node):
        key = self._hash(node)
        if key in self.hash_ring:
            del self.hash_ring[key]
            self.sorted_keys.remove(key)
        self.nodes.remove(node)

    def get_node(self, request_key):
        if not self.hash_ring:
            return None
        hash_key = self._hash(request_key)
        for key in self.sorted_keys:
            if hash_key <= key:
                return self.hash_ring[key]
        return self.hash_ring[self.sorted_keys[0]]

ch = ConsistentHash(['Node1', 'Node2', 'Node3'])
print(ch.get_node('User_A'))
ch.remove_node('Node2')
print(ch.get_node('User_A'))
在该示例中,用户请求 'User_A' 会被映射到哈希环上的特定位置,并顺时针找到最近的节点。当移除 Node2 时,原本指向 Node2 的请求可能会迁移到下一个节点,但其他用户的请求路径保持不变。这种特性使得一致性哈希成为维护会话状态和分布式缓存一致性的理想选择,特别是在节点动态扩缩容的场景下。
哈希冲突对请求路由的影响
在使用一致性哈希或普通哈希算法时,不同的输入键可能计算出相同的哈希值,导致请求被错误地路由到同一节点,或者在节点变化时引发不必要的重分布。虽然哈希冲突在理论上不可避免,但在实际配置中,通过增加虚拟节点(Virtual Nodes)可以有效分散热点,减少因单个物理节点故障或负载不均带来的影响。
class VirtualNodeConsistentHash:
    def __init__(self, nodes=None, virtual_nodes=150):
        self.virtual_nodes = virtual_nodes
        self.hash_ring = {}
        self.sorted_keys = []
        self.physical_nodes = nodes or []
        if nodes:
            for node in nodes:
                self.add_node(node)

    def _hash(self, key):
        return hash(key) % (2**32 - 1)

    def add_node(self, physical_node):
        for i in range(self.virtual_nodes):
            virtual_node_name = f"{physical_node}_vnode_{i}"
            key = self._hash(virtual_node_name)
            self.hash_ring[key] = physical_node
            self.sorted_keys.append(key)
        self.sorted_keys.sort()

    def get_node(self, request_key):
        if not self.hash_ring:
            return None
        hash_key = self._hash(request_key)
        for key in self.sorted_keys:
            if hash_key <= key:
                return self.hash_ring[key]
        return self.hash_ring[self.sorted_keys[0]]

vn_ch = VirtualNodeConsistentHash(['Server_X'], virtual_nodes=10)
print(vn_ch.get_node('Request_1'))
print(vn_ch.get_node('Request_2'))
引入虚拟节点后,每个物理节点在哈希环上占据多个位置。即使发生哈希冲突,请求也会更均匀地分布在不同的虚拟节点上,进而映射到不同的物理节点。这种方式不仅缓解了哈希冲突带来的负载不均问题,还提高了系统在节点故障时的容错能力,确保请求能够平滑过渡到其他可用节点。






















