








在 docker 中实时获取 docker stats 数据,最可靠的方式是使用 python 的 docker sdk 调用 client.stats() 方法。该方法会返回一个生成器,通过迭代它即可逐条接收容器的 cpu、内存和网络 i/o 等实时指标。若需同时监控多个容器,可遍历容器列表并分别调用该接口,从而避免解析命令行输出的繁琐与不稳定。

如何配置参数以控制刷新频率和输出内容
要控制数据获取的频率和内容,需在调用 Client.stats() 时传入 stream 和 decode 参数。stream=True 是必须的,否则 API 只会返回初始快照而非持续流;decode=True 则让 SDK 自动将 JSON 响应解码为 Python 字典,方便直接访问字段。默认情况下,Docker Daemon 会以每秒一次的频率推送数据,你可以通过设置环境变量或修改 Daemon 配置来调整全局刷新率,但在 Python 脚本层面,主要通过控制迭代循环的速度来实现“伪”频率调节。
import docker

# 创建客户端连接
client = docker.from_env()

# 获取所有运行中的容器
containers = client.containers.list()

for container in containers:
    # 调用 stats 方法,开启流式传输并自动解码
    stats_stream = container.stats(stream=True, decode=True)

    try:
        while True:
            # 从生成器中获取最新一帧数据
            stats_data = next(stats_stream)

            # 提取关键指标
            cpu_percent = stats_data.get('cpu_stats', {}).get('cpu_usage', {}).get('total_usage', 0)
            system_cpu = stats_data.get('cpu_stats', {}).get('system_cpu_usage', 0)
            mem_usage = stats_data.get('memory_stats', {}).get('usage', 0)
            mem_limit = stats_data.get('memory_stats', {}).get('limit', 0)

            print(f"Container: {container.name} | CPU: {cpu_percent} | Mem: {mem_usage}/{mem_limit}")

            # 模拟每秒刷新,实际频率取决于 daemon 推送间隔
            import time
            time.sleep(1)
    except GeneratorExit:
        pass
    except Exception as e:
        print(f"Error monitoring {container.name}: {e}")
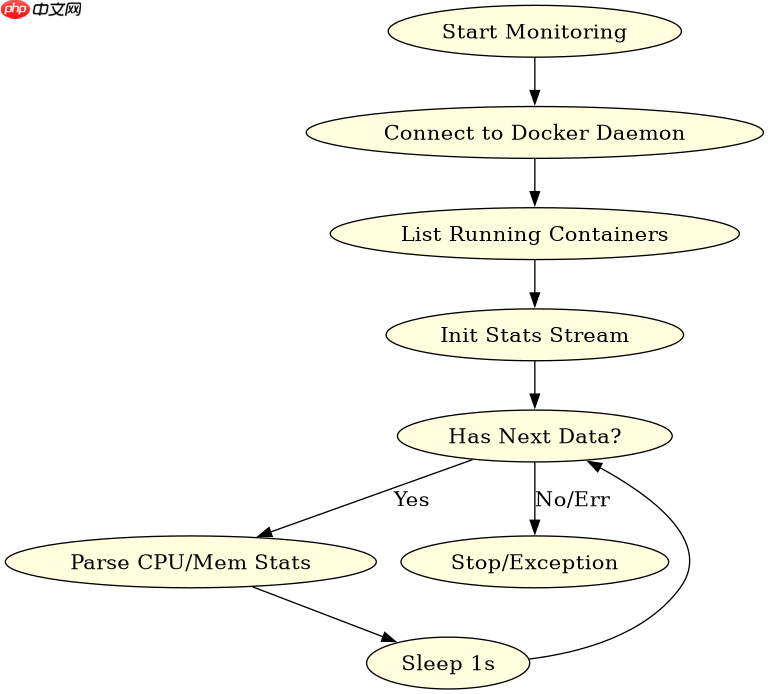
上述代码展示了完整的监控逻辑。首先通过 client.containers.list() 获取目标容器,然后对每个容器启动 stats 流。在循环中,next(stats_stream) 会阻塞直到收到新数据。提取出的 cpu_stats 和 memory_stats 包含了详细的原始值,开发者可根据需要进行归一化或计算百分比。注意处理 GeneratorExit 异常,以便在容器停止或脚本退出时优雅地关闭资源。
立即学习“Python免费学习笔记(深入)”;

Camoufox 是一个基于 Firefox 构建的开源反检测浏览器,为 Python 自动化工作流程提供强大的指纹注入和反机器人检测规避功能。它与 Playwright 集成,以提供能够绕过现代机器人检测系统的隐身浏览能力。
如何处理多容器并发监控时的数据冲突与资源占用
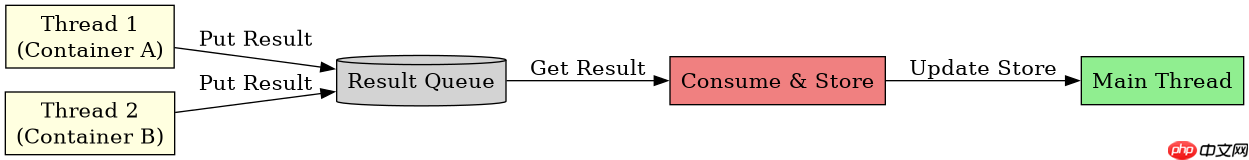
当同时监控多个容器时,直接串行调用 container.stats() 会导致数据更新不同步,且单个容器的网络阻塞可能影响其他容器的监控。为解决此问题,应使用多线程或异步 IO 为每个容器分配独立的监控任务。每个线程独立维护自己的 stats 生成器,确保数据流的隔离性。此外,需注意 Docker Daemon 的资源限制,过多并发的 stats 请求可能导致 Daemon 负载升高,建议通过队列缓冲数据或限制监控容器的数量。
import docker
import threading
import queue
import time

# 定义一个安全的数据存储结构
data_store = {}
lock = threading.Lock()

def monitor_container(container_name, stats_stream, result_queue):
    try:
        while True:
            stats_data = next(stats_stream)
            # 构造简洁的监控结果
            result = {
                'name': container_name,
                'cpu': stats_data.get('cpu_stats', {}).get('cpu_usage', {}).get('total_usage', 0),
                'mem': stats_data.get('memory_stats', {}).get('usage', 0),
                'timestamp': time.time()
            }
            result_queue.put(result)
    except Exception as e:
        print(f"Thread for {container_name} failed: {e}")

# 主程序
client = docker.from_env()
containers = client.containers.list()
result_queue = queue.Queue(maxsize=100)  # 缓冲队列,防止内存溢出

threads = []
for container in containers:
    # 为每个容器启动独立的统计流
    stream = container.stats(stream=True, decode=True)
    t = threading.Thread(target=monitor_container, args=(container.name, stream, result_queue))
    t.daemon = True
    t.start()
    threads.append(t)

# 主线程消费数据
try:
    while True:
        if not result_queue.empty():
            data = result_queue.get_nowait()
            with lock:
                data_store[data['name']] = data
            print(f"Updated: {data['name']} at {data['timestamp']}")
        time.sleep(0.5)
except KeyboardInterrupt:
    print("Stopping...")
该并发模型通过 threading 模块实现并行监控。每个容器拥有独立的线程和 stats 流,避免了串行调用的延迟问题。数据通过 queue.Queue 传递给主线程进行统一处理,这种生产者-消费者模式能有效解耦数据采集与业务逻辑。使用 maxsize 限制队列长度,防止因数据处理过慢导致内存堆积。在实际生产中,可根据监控粒度调整 time.sleep 的间隔,以及队列的大小,以平衡实时性与系统资源消耗。
基于程序中某个输入、条件或结果的具体问题
在实时监控过程中,如果容器被删除或重启,container.stats() 生成的迭代器会抛出异常或停止产生新数据。这是因为底层的 Docker Socket 连接已随容器生命周期结束而断开。此时,脚本需要捕获此类异常,并重新查询容器状态。若容器已不存在,应将其从监控列表中移除;若容器已重启,可能需要重新获取新的容器 ID 并建立新的监控流。这一机制确保了监控系统的鲁棒性,避免因个别容器故障导致整个监控进程崩溃。


















