








在java中,自定义异常通过继承 exception 类并添加一个整型的 errorcode 字段来区分错误类型。具体做法是在构造函数中接收该错误码并赋值给成员变量,同时在类中提供 geterrorcode() 方法供调用者获取。这样,捕获异常后只需调用该方法即可判断具体的业务错误场景,而无需依赖异常类的名称或消息。
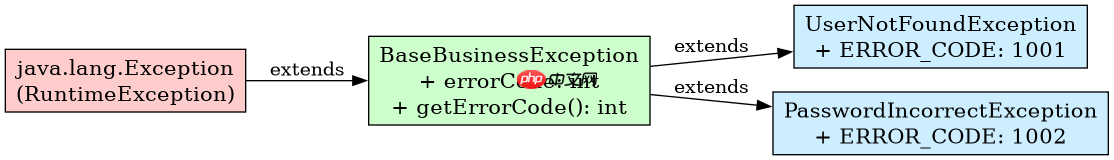
如何设计支持错误码的自定义异常基类
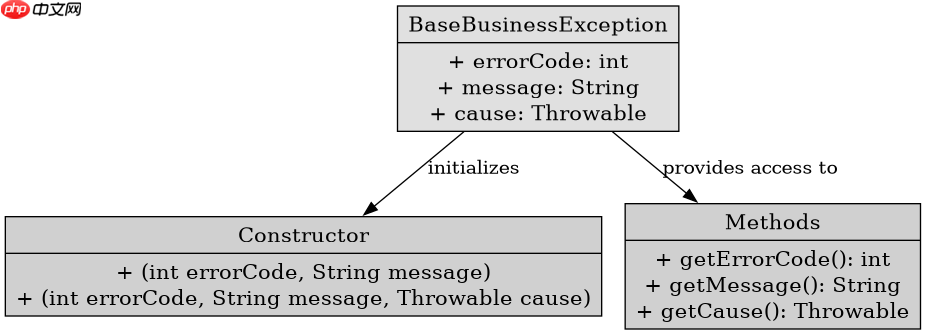
创建一个通用的基类 BaseBusinessException,它包含 errorCode、message 和 cause 三个核心属性。这个基类负责处理所有子类共有的逻辑,确保每个异常实例都能携带唯一的错误标识。
public class BaseBusinessException extends RuntimeException {
    private final int errorCode;

    public BaseBusinessException(int errorCode, String message) {
        super(message);
        this.errorCode = errorCode;
    }

    public BaseBusinessException(int errorCode, String message, Throwable cause) {
        super(message, cause);
        this.errorCode = errorCode;
    }

    public int getErrorCode() {
        return errorCode;
    }
}
上述代码定义了一个标准的异常基类。构造时传入的错误码会被保存。调用者可以通过 getErrorCode() 直接获取整数类型的错误码,这比解析字符串消息更高效且易于程序化处理。例如,错误码 1001 可能代表“用户不存在”,1002 代表“密码错误”。
立即学习“Java免费学习笔记(深入)”;

如何创建具体的业务异常类
针对特定的业务场景,继承 BaseBusinessException 创建具体的异常类。通常不需要重写构造函数,只需定义常量化的错误码即可。这种方式保持了代码的整洁性,同时明确了异常的语义。
public class UserNotFoundException extends BaseBusinessException {
    public static final int ERROR_CODE = 1001;

    public UserNotFoundException(String userId) {
        super(ERROR_CODE, "User not found: " + userId);
    }
}

public class PasswordIncorrectException extends BaseBusinessException {
    public static final int ERROR_CODE = 1002;

    public PasswordIncorrectException() {
        super(ERROR_CODE, "Password is incorrect");
    }
}
这里定义了 UserNotFoundException 和 PasswordIncorrectException。它们各自拥有固定的错误码。在实际使用中,当业务逻辑检测到用户ID无效时,抛出 UserNotFoundException;当密码校验失败时,抛出 PasswordIncorrectException。调用方捕获这些异常后,可以统一通过 getErrorCode() 进行路由处理,比如返回不同的HTTP状态码或前端提示信息。
基于 errorCode 1001 的具体处理逻辑
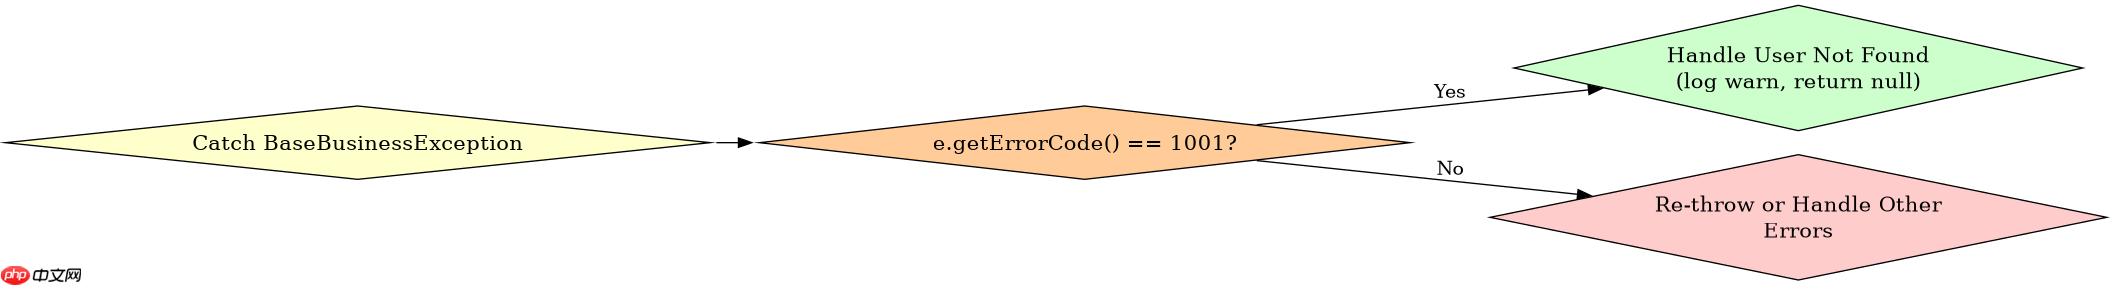
当程序中抛出错误码为 1001 的异常时,表示目标资源(如用户)未找到。在处理层,可以根据这个特定的错误码执行降级策略或记录特定日志。
public void handleUserRequest(String userId) {
    try {
        userService.findUser(userId);
    } catch (BaseBusinessException e) {
        if (e.getErrorCode() == 1001) {
            // 记录用户查找失败的日志
            log.warn("User lookup failed for id: {}", userId);
            // 返回默认值或友好提示
            return null;
        } else {
            // 其他错误码的处理逻辑
            throw e;
        }
    }
}
这段代码展示了如何在实际业务中利用错误码进行分支判断。如果捕获到的异常错误码等于 1001,则执行特定的恢复逻辑。这种基于数值比较的判断方式比使用 instanceof 检查异常类型更加灵活,因为多个不同的异常类可以共享相同的错误码,或者同一个异常类在不同上下文中可以使用不同的错误码(虽然本例中是固定常量)。这使得错误分类更加细粒度,便于监控和统计。

















