








java 的 char 类型基于 utf-16 编码,处理中文和特殊字符的核心在于理解代理对(surrogate pairs)机制。对于基本多文种平面(bmp)内的字符如常用汉字,一个 char 即可完整存储;而对于辅助平面字符如 emoji 或生僻字,则需要两个 char 组成代理对来表示。开发者在处理时应避免直接使用 char 进行长度计算或索引访问,而应使用 string.codepointat() 和 string.length() 等方法来确保逻辑正确。
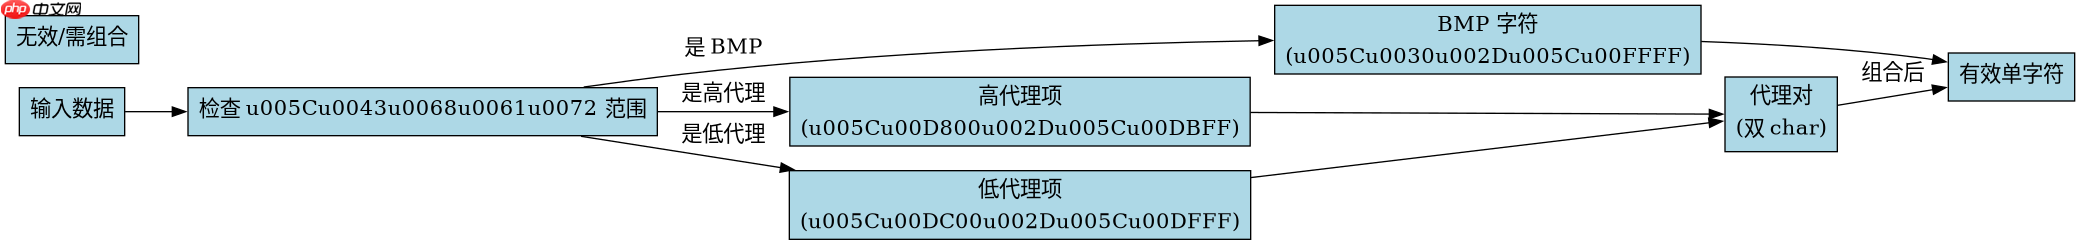
如何判断单个 char 是否为有效字符
要判断一个 char 是否代表一个完整的 Unicode 字符,需检查其是否位于代理对区间。若 char 值在 \uD800 到 \uDBFF 之间,则为高代理项;若在 \uDC00 到 \uDFFF 之间,则为低代理项。单独的高或低代理项不构成有效字符,必须成对出现。通过检查范围可快速识别是否需要组合处理。
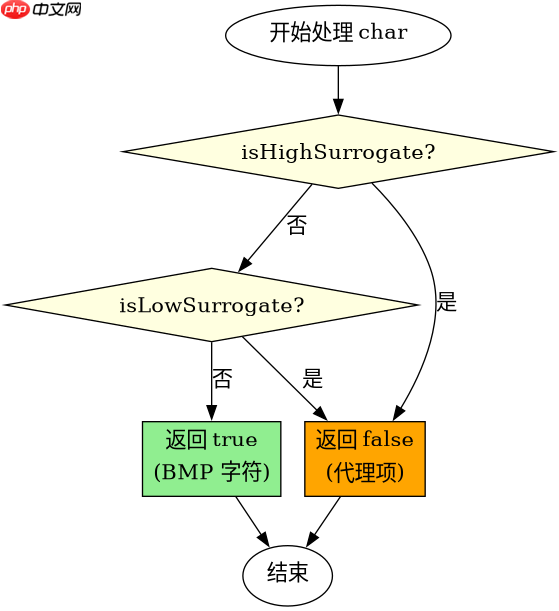
public class CharCheck {
    public static void main(String[] args) {
        char c1 = '中'; // BMP 字符
        char high = '\uD83D'; // 高代理项 (Emoji 起始)
        char low = '\uDE00'; // 低代理项 (Emoji 结束)

        System.out.println("Is BMP: " + !Character.isHighSurrogate(c1) && !Character.isLowSurrogate(c1));
        System.out.println("Is High Surrogate: " + Character.isHighSurrogate(high));
        System.out.println("Is Low Surrogate: " + Character.isLowSurrogate(low));
    }
}
如何将 char 数组转换为完整字符串
将 char 数组转换为字符串时,直接构造 String 对象即可保留所有字符信息,包括代理对。但需注意,若手动遍历 char 数组并尝试以单字符为单位处理业务逻辑(如计数),会导致代理对字符被错误拆分。推荐使用 String.codePoints() 流式处理,确保每个 Unicode 标量值被视为一个单元。

立即学习“Java免费学习笔记(深入)”;
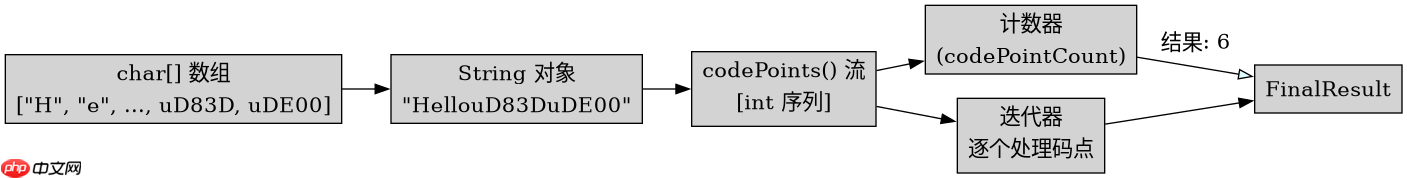
public class StringConversion {
    public static void main(String[] args) {
        char[] chars = {'H', 'e', 'l', 'l', 'o', '\uD83D', '\uDE00'};
        String str = new String(chars);

        System.out.println("Char length: " + chars.length); // 7
        System.out.println("String length: " + str.length()); // 7
        System.out.println("Code point count: " + str.codePointCount(0, str.length())); // 6

        // 正确遍历方式
        str.codePoints().forEach(cp -> System.out.println((char) cp));
    }
}
代理对在内存中的实际布局
在 Java 虚拟机中,char 占用 2 字节。对于 BMP 字符,内存中仅存储一个 2 字节值;对于辅助平面字符,则连续存储两个 2 字节值:高代理项和低代理项。这种布局使得 char 数组在随机访问时可能截断字符,因此在需要按字符而非码元操作时,必须转换为 String 或使用 int 类型的码点序列。实际开发中,建议优先使用 String 和 int 码点 API,避免直接操作 char 引发边界错误。


















