








Java 字节流与字符流中 怎么复制流内容
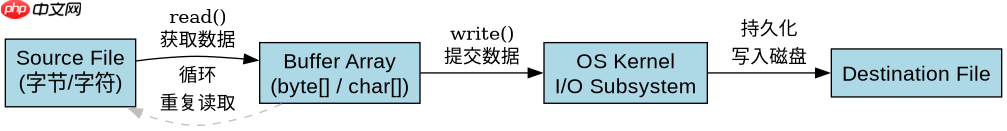
在 java 中,复制流内容的核心方法是使用缓冲流(bufferedinputstream/bufferedreader 和 bufferedoutputstream/bufferedwriter)配合一个固定大小的缓冲区数组进行循环读写。对于字节流,直接读取字节并写入目标流;对于字符流,则读取字符数组或字符串并写入目标流。这种基于缓冲区的 i/o 操作能显著减少系统调用次数,从而提升文件复制的性能。
字节流复制的具体实现与注意事项
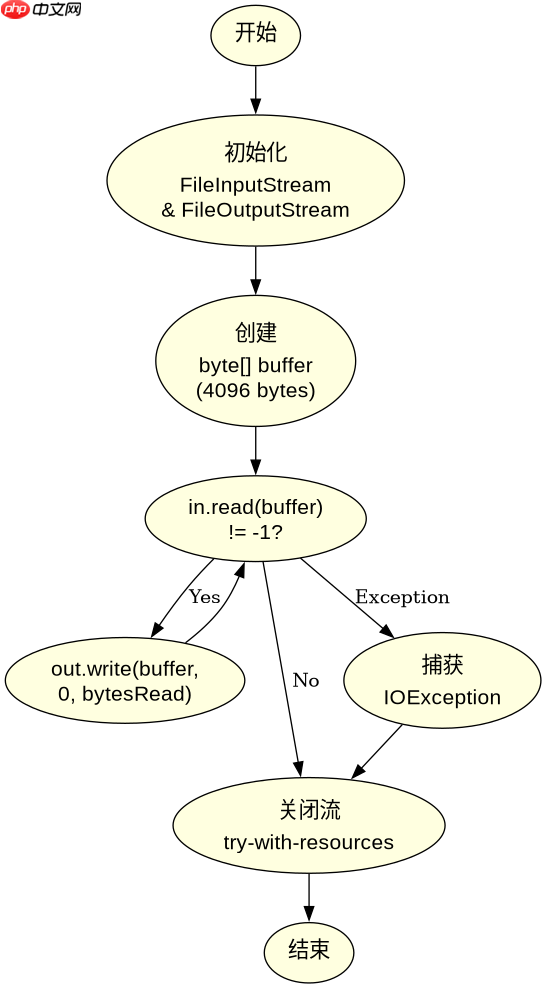
针对字节流(如 FileInputStream 和 FileOutputStream),最标准的做法是创建一个中等大小的字节数组作为缓冲区(例如 4KB 或 8KB),然后在一个 while 循环中调用 read() 方法,直到返回 -1 表示文件结束。每次读取后,立即将缓冲区中的数据通过 write() 方法写入输出流。需要注意的是,必须确保在操作完成后关闭流,通常使用 try-with-resources 语句来自动管理资源,防止内存泄漏或文件句柄未释放的问题。
import java.io.*;

public class ByteStreamCopy {
    public static void main(String[] args) {
        // 定义源文件和目标文件路径
        String srcPath = "source.bin";
        String destPath = "dest.bin";

        // 使用 try-with-resources 自动关闭流
        try (InputStream in = new FileInputStream(srcPath);
             OutputStream out = new FileOutputStream(destPath)) {

            // 创建缓冲区,大小设为 4096 字节
            byte[] buffer = new byte[4096];
            int bytesRead;

            // 循环读取直到返回 -1
            while ((bytesRead = in.read(buffer)) != -1) {
                // 将读取到的数据写入输出流
                out.write(buffer, 0, bytesRead);
            }
            System.out.println("字节流复制完成。");

        } catch (IOException e) {
            e.printStackTrace();
        }
    }
}
上述代码的预期结果是:如果 source.bin 存在且可读,程序会将其内容完整复制到 dest.bin 中。若源文件不存在,将抛出 FileNotFoundException。缓冲区大小影响性能,但 4KB-8KB 通常是平衡内存占用和 I/O 效率的合理选择。返回值 bytesRead 表示本次实际读取的字节数,可能小于缓冲区长度,特别是在读取文件的最后一段时。
立即学习“Java免费学习笔记(深入)”;

使用Atmosphere构建通过WebSocket、SSE、gRPC、WebTransport、MCP、A2A和AG-UI流传输的JVM代理网关,并带有治理钩子。
字符流复制的具体实现与编码处理
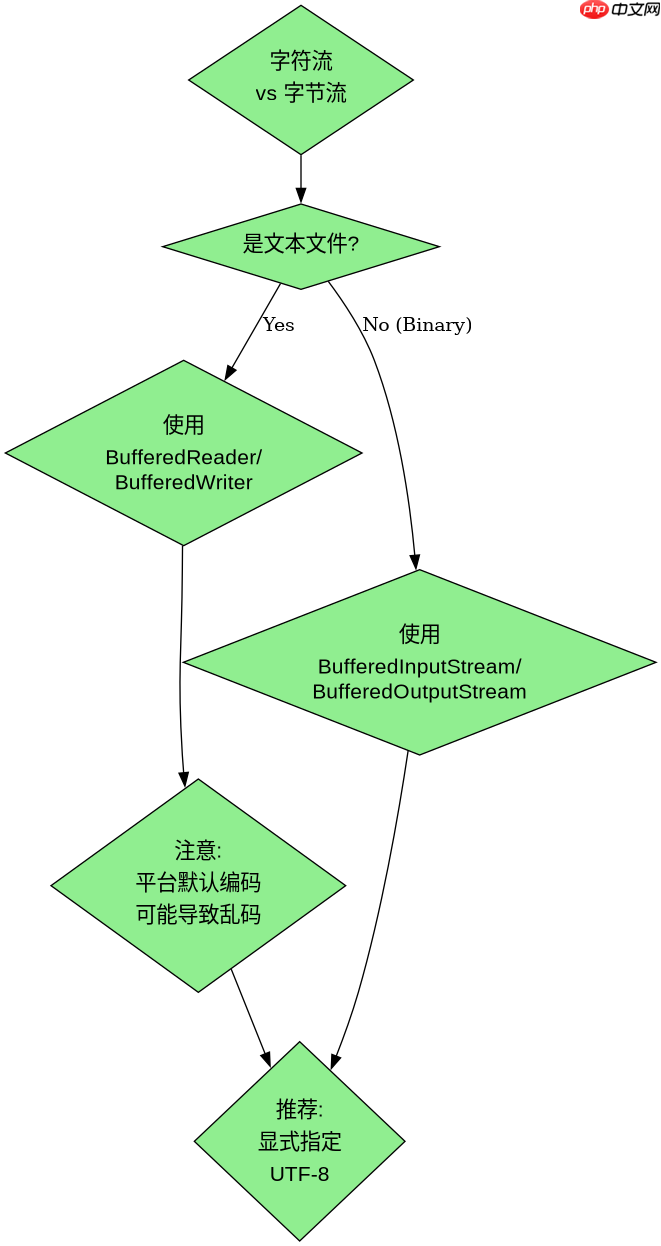
字符流(如 FileReader 和 FileWriter)主要用于处理文本数据,其底层会自动进行字节到字符的转换。复制字符流时,同样推荐使用 BufferedReader 和 BufferedWriter。可以通过 read(char[] buf) 方法读取字符数组,或者使用 readLine() 逐行读取。对于纯文本复制,逐行读取并写入是一种常见且安全的做法,因为它能保留换行符结构。然而,需要注意字符流的默认编码可能与文件实际编码不一致,导致乱码。因此,更推荐显式指定编码,或使用 InputStreamReader 和 OutputStreamWriter 包装字节流以控制编码。
import java.io.*;

public class CharStreamCopy {
    public static void main(String[] args) {
        String srcPath = "source.txt";
        String destPath = "dest.txt";

        try (BufferedReader reader = new BufferedReader(new FileReader(srcPath));
             BufferedWriter writer = new BufferedWriter(new FileWriter(destPath))) {

            char[] buffer = new char[1024];
            int charsRead;

            // 循环读取字符数组
            while ((charsRead = reader.read(buffer)) != -1) {
                // 写入字符数组
                writer.write(buffer, 0, charsRead);
            }
            System.out.println("字符流复制完成。");

        } catch (IOException e) {
            e.printStackTrace();
        }
    }
}
该代码的预期结果是:将 source.txt 中的文本内容复制到 dest.txt。由于使用了 FileReader 和 FileWriter,它们会使用平台默认的字符集(如 Windows 上的 GBK 或 Linux 上的 UTF-8)。如果文件编码与平台默认编码不一致,可能会出现乱码。在实际开发中,建议明确指定编码,例如使用 new InputStreamReader(new FileInputStream(srcPath), StandardCharsets.UTF_8) 来确保跨平台兼容性。此方法适用于文本文件,不适用于二进制文件,因为字符流可能会破坏非文本数据的结构。
当源文件大小超过可用内存时会发生什么
当源文件大小超过可用内存时,基于缓冲区的流复制方法依然有效,因为它并不将整个文件加载到内存中,而是只占用缓冲区大小的内存空间。无论文件多大(只要磁盘空间足够),程序都会按块读取和写入,内存占用保持恒定。这意味着该方法具有线性时间复杂度和常数级空间复杂度,适合处理大文件。唯一的风险是磁盘 I/O 瓶颈,而非内存溢出。如果文件极大,可以考虑增加缓冲区大小以提升 I/O 吞吐量,但需权衡内存消耗。



















