








java 字节流与字符流中,底层缓冲区复用主要通过包装类(如 bufferedinputstream、bufferedreader)实现。开发者只需将目标流传入构造函数,库会自动分配并管理内部数组;读取时若缓冲为空则自动从底层填充,写满后自动刷新,无需手动干预数组生命周期。

字节流缓冲区如何自动扩容与复用
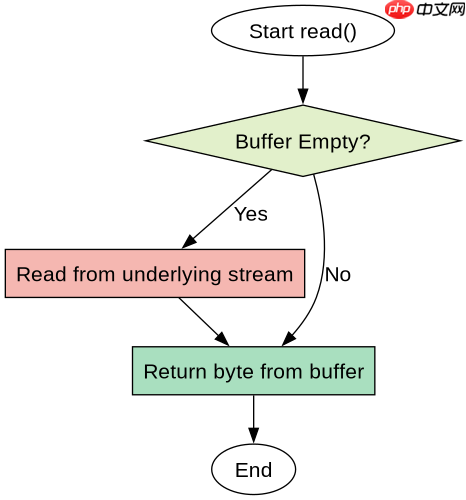
在 BufferedInputStream 中,默认使用 8KB 的 byte[] buffer。当调用 read() 且缓冲耗尽时,它会向底层流请求数据并覆盖原数组,实现复用。若需自定义大小,可在构造时指定容量。
import java.io.*;

public class ByteStreamDemo {
    public static void main(String[] args) throws IOException {
        // 创建带缓冲的字节输入流,指定缓冲区大小为 4096 字节
        try (BufferedInputStream bis = new BufferedInputStream(
                new FileInputStream("data.bin"), 4096)) {
            int data;
            while ((data = bis.read()) != -1) {
                System.out.print((char) data);
            }
        }
    }
}
运行上述代码,程序会按 4096 字节块读取文件内容。每次 read() 触发底层 I/O 时,buffer 数组会被重新填充,旧数据被丢弃,从而实现内存复用。
立即学习“Java免费学习笔记(深入)”;

Build Java agent transport gateways with Atmosphere
下载
使用Atmosphere构建通过WebSocket、SSE、gRPC、WebTransport、MCP、A2A和AG-UI流传输的JVM代理网关,并带有治理钩子。
字符流缓冲区如何处理编码转换
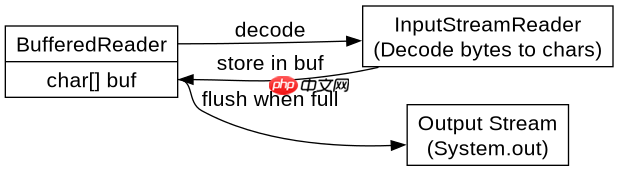
BufferedReader 内部维护一个 char[] buf,默认大小为 8KB。它在读取字节后,通过 InputStreamReader 进行解码,将结果存入字符缓冲。当缓冲满或遇到换行符时,返回给上层应用。这种机制避免了逐字节解码的性能损耗。
import java.io.*;

public class CharStreamDemo {
    public static void main(String[] args) throws IOException {
        // 创建带缓冲的字符输入流,指定缓冲区大小为 2048 个字符
        try (BufferedReader br = new BufferedReader(
                new InputStreamReader(
                    new FileInputStream("text.txt"), "UTF-8"), 2048)) {
            String line;
            while ((line = br.readLine()) != null) {
                System.out.println(line);
            }
        }
    }
}
执行该程序时,br 会批量读取字节并解码为字符。若缓冲区剩余空间不足,它会自动扩展或清空,确保高效处理文本数据。
基于程序中某个输入、条件或结果的具体问题
当输入数据量小于缓冲区大小时,缓冲区不会完全填满,但依然会复用。例如,若文件仅 100 字节,而缓冲区设为 4096,read() 只会填充前 100 字节,后续调用直接返回 -1。此时缓冲区未被重复利用,但内存已分配。若需优化小文件场景,可减小缓冲区尺寸或改用无缓冲流。



















