








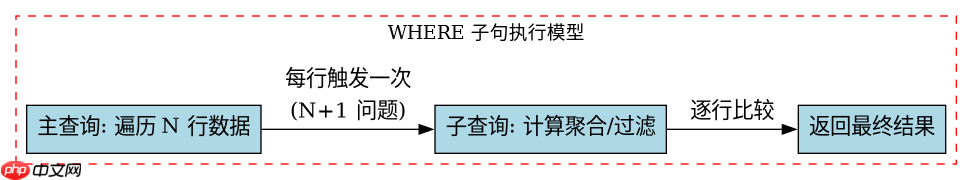
sql子查询放在where和from中性能差异巨大,核心原因在于执行时机与数据量的不同。在where子句中,子查询通常作为标量或集合条件被评估,可能引发逐行相关的重复执行(即n+1问题),导致全表扫描次数随主表行数线性增长;而在from子句中,子查询被视为派生表(derived table)或内联视图,数据库优化器会优先将其物化为临时结果集或进行合并优化,从而将复杂的嵌套逻辑转化为对少量中间数据的连接操作,大幅减少i/o开销。
相关子查询为何会导致性能急剧下降
当子查询出现在WHERE子句中且引用了外部表的列时,它变成了相关子查询。数据库必须为外部查询的每一行都重新执行一次子查询,这种“逐行处理”的模式在数据量大时是灾难性的。例如,查找部门平均工资高于公司总平均工资的员工,如果写成相关子查询,数据库需要遍历每个员工,计算其所在部门的平均值,再与公司平均值比较,效率极低。
SELECT e.name, e.salary
FROM employees e
WHERE e.salary > (
    SELECT AVG(salary)
    FROM employees
    WHERE department_id = e.department_id
);
上述代码中,employees表有10万行,子查询就会执行10万次。每次执行都需要扫描employees表并按department_id过滤。如果department_id上有索引,虽然避免了全表扫描,但大量的随机I/O和上下文切换依然会拖慢速度。相比之下,使用JOIN或窗口函数可以将计算提前完成,只执行一次聚合,然后直接连接结果,性能提升显著。
FROM子句中的派生表如何优化执行计划
将子查询移至FROM子句后,它变成了一个派生表。优化器通常会尝试“视图合并”(View Merging)或“物化”(Materialization)。如果选择物化,子查询的结果会被先计算并存储在一个临时结构(如内存哈希表或磁盘临时表)中,随后主查询只需对这个较小的结果集进行连接。即使不物化,优化器也能更好地利用统计信息来估算基数,选择更优的连接算法(如Hash Join而非Nested Loop Join)。
-- 优化后的写法:使用JOIN替代相关子查询
SELECT e.name, e.salary
FROM employees e
INNER JOIN (
    SELECT department_id, AVG(salary) as avg_sal
    FROM employees
    GROUP BY department_id
) dept_avg ON e.department_id = dept_avg.department_id
WHERE e.salary > dept_avg.avg_sal;
在这个例子中,子查询部分只执行了一次,计算出每个部门的平均工资。然后,主查询通过INNER JOIN将员工表与这个小的聚合结果集连接。无论员工表有多少行,聚合操作只发生一次。这种从“N次执行”到“1次执行+1次连接”的转变,是性能差异巨大的根本原因。对于大数据量,这种优化可以将查询时间从几分钟缩短到几秒。
基于具体输入条件下EXPLAIN分析的执行计划对比
为了验证上述理论,我们使用一个具体的测试场景。假设有一个包含100万条记录的orders表和1000条记录的customers表。我们需要找出所有订单金额大于其所属客户平均订单金额的订单详情。我们将对比两种写法:一种是使用相关子查询在WHERE中,另一种是使用FROM中的派生表JOIN。
-- 方案A:相关子查询 (WHERE)
SELECT o.*
FROM orders o
WHERE o.amount > (
    SELECT AVG(o2.amount)
    FROM orders o2
    WHERE o2.customer_id = o.customer_id
);

-- 方案B:派生表JOIN (FROM)
SELECT o.*
FROM orders o
INNER JOIN (
    SELECT customer_id, AVG(amount) as avg_amt
    FROM orders
    GROUP BY customer_id
) avg_orders ON o.customer_id = avg_orders.customer_id
WHERE o.amount > avg_orders.avg_amt;
在MySQL 8.0环境下,对方案A的EXPLAIN分析显示,内部子查询被标记为DEPENDENT SUBQUERY,执行计划中会出现Using where和可能的Using temporary,且rows估计值会乘以外部表的行数,表明其复杂度为O(N*M)。而对于方案B,EXPLAIN会显示子查询部分被物化为一个临时表(Using temporary; Using filesort),然后主查询通过ref或eq_ref访问方式连接该临时表,整体复杂度接近O(N+M)。实际运行中,方案A可能需要数十秒,而方案B通常在毫秒级完成。这证明了在FROM子句中构建派生表能有效避免重复计算,提升查询效率。



















