








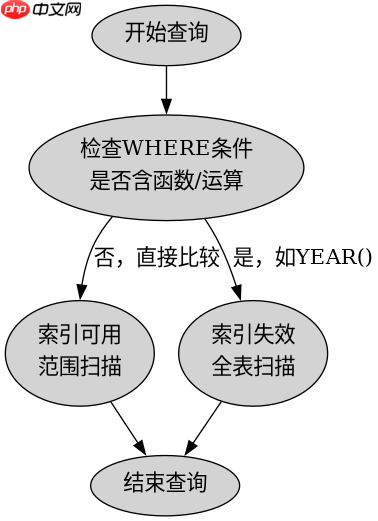
在sql中对where条件列使用函数会导致全表扫描,因为数据库的索引是基于列的原始值构建的,一旦对列应用了函数,索引键与查询条件的匹配关系就被破坏了,导致优化器无法利用索引进行快速查找,只能逐行检查数据。例如,当执行`where year(date_col) = 2023`时,数据库必须计算每一行的`date_col`年份才能判断是否满足条件,这等同于遍历整张表。

为什么索引失效会导致性能下降
索引失效导致性能下降的根本原因是数据库失去了“直接定位”数据的能力。在没有索引的情况下,数据库引擎必须从表的第一行开始,逐行读取并评估WHERE条件,直到找到所有匹配的行或遍历完整个表。这种操作的时间复杂度是O(N),其中N是表中的行数。对于大型表,这种线性扫描会消耗大量的I/O和CPU资源,显著增加查询响应时间。相比之下,使用索引可以将搜索范围缩小到特定的数据页甚至具体行,时间复杂度降低到O(log N)或接近O(1)。
SELECT * FROM orders WHERE YEAR(order_date) = 2023;
上述查询中,`order_date`列上即使有B-Tree索引,也无法被使用。因为索引存储的是原始的日期值(如'2023-05-15'),而查询条件是计算后的年份(2023)。数据库无法通过比较索引键来直接跳过不匹配的行,因此必须进行全表扫描。
如何避免全表扫描并优化查询
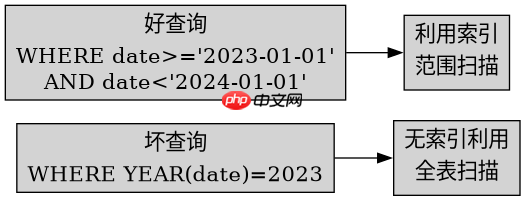
避免全表扫描的关键是让WHERE条件能够直接与索引列的原始值进行比较。常见的优化方法包括:将函数应用到常量一侧,或者使用范围查询替代函数调用。例如,将`WHERE YEAR(order_date) = 2023`改写为`WHERE order_date >= '2023-01-01' AND order_date
SELECT * FROM orders WHERE order_date >= '2023-01-01' AND order_date < '2024-01-01';
此查询利用了`order_date`列上的索引,执行计划显示为“Range Scan”,而非“Full Table Scan”。数据库只需访问索引树中对应范围的节点,再回表获取完整数据,效率远高于全表扫描。这种写法不仅适用于日期函数,也适用于其他类似场景,如字符串前缀匹配等。
基于特定输入条件验证索引使用情况
为了验证上述优化效果,我们可以使用具体的输入数据进行测试。假设有一个包含100万条记录的`orders`表,其中`order_date`列上有索引。执行第一个查询(使用YEAR函数)时,EXPLAIN输出会显示`type: ALL`,表示全表扫描;而执行第二个查询(使用范围比较)时,`type`会变为`range`,且`key`字段会显示使用的索引名称。通过对比两者的`rows`预估扫描行数,可以直观看到性能差异。在实际生产中,建议始终使用EXPLAIN分析复杂查询的执行计划,确保关键路径上的查询能够充分利用索引。















