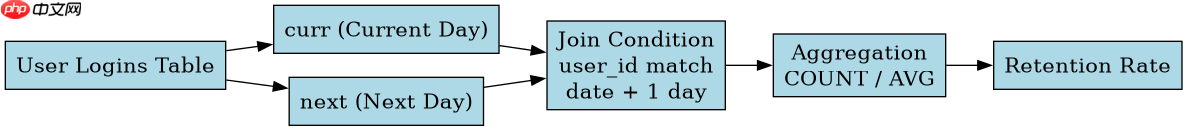
在sql中通过自连接配合聚合函数计算留存率,核心做法是将同一张表按用户id进行自连接,利用时间差条件匹配“活跃”与“回访”记录,再使用count和avg等聚合函数统计比例。具体而言,将表别名为当前期(如`curr`)和历史期(如`prev`),关联条件为`curr.user_id = prev.user_id`且`curr.date = prev.date + interval`,最后对历史期的存在性进行布尔聚合或计数除以总数,即可得出留存率。
如何编写基础的用户次日留存查询
基础查询通过自连接筛选出在第二天依然存在的用户,并使用COUNT聚合计算留存人数占总人数的比例。假设有一张包含用户登录日志的表`user_logins`,其中包含`user_id`和`login_date`字段。我们需要找出第一天登录的用户,并检查他们在第二天是否再次登录。通过左连接(LEFT JOIN)确保即使没有次日登录的用户也被保留,从而准确计算分母。
SELECT
    COUNT(DISTINCT curr.user_id) AS total_users,
    COUNT(DISTINCT next.user_id) AS retained_users,
    AVG(CASE WHEN next.user_id IS NOT NULL THEN 1.0 ELSE 0.0 END) AS retention_rate
FROM user_logins curr
LEFT JOIN user_logins next
    ON curr.user_id = next.user_id
    AND next.login_date = curr.login_date + INTERVAL '1 day'
WHERE curr.login_date = '2023-10-01';
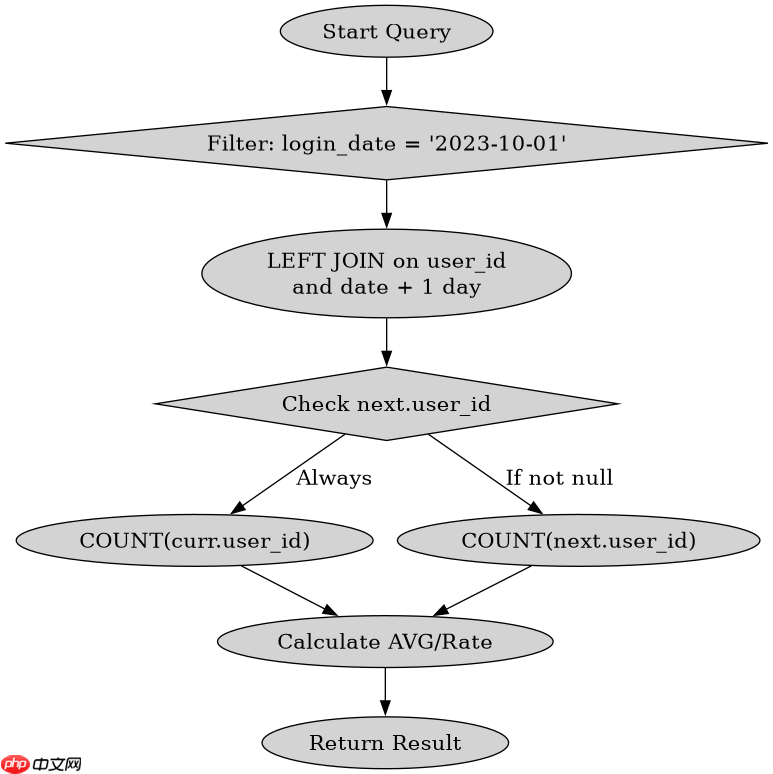
上述代码首先筛选出特定日期(如2023-10-01)的所有首次或当日登录用户作为基准组(`curr`)。接着,尝试在`user_logins`表中寻找相同`user_id`且在次日(`+ INTERVAL '1 day'`)有登录记录的行(`next`)。如果找到匹配行,`next.user_id`不为空;否则为空。`AVG`函数结合`CASE`表达式将非空值视为1,空值视为0,其平均值即为留存率。`COUNT(DISTINCT ...)`用于处理同一用户多次登录的情况,确保每个用户只被计算一次。
如何扩展计算多日周期留存率
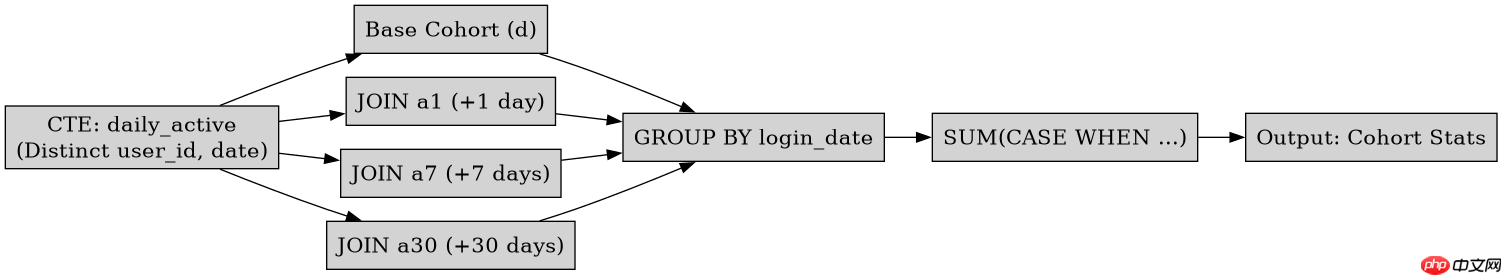
扩展计算需要引入时间窗口概念,通常通过生成日期序列或使用子查询来对比不同天数的留存情况。为了同时获取第1、7、30天的留存率,可以将自连接的条件参数化,或者使用多个自连接。更通用的方法是使用`GROUP BY`对初始登录日期分组,并在连接条件中使用不同的间隔天数。
WITH daily_active AS (
    SELECT DISTINCT user_id, login_date
    FROM user_logins
    WHERE login_date BETWEEN '2023-10-01' AND '2023-10-07'
)
SELECT
    d.login_date AS cohort_date,
    COUNT(DISTINCT d.user_id) AS cohort_size,
    SUM(CASE WHEN a1.user_id IS NOT NULL THEN 1 ELSE 0 END) AS day_1_retained,
    SUM(CASE WHEN a7.user_id IS NOT NULL THEN 1 ELSE 0 END) AS day_7_retained,
    SUM(CASE WHEN a30.user_id IS NOT NULL THEN 1 ELSE 0 END) AS day_30_retained
FROM daily_active d
LEFT JOIN daily_active a1
    ON d.user_id = a1.user_id AND a1.login_date = d.login_date + INTERVAL '1 day'
LEFT JOIN daily_active a7
    ON d.user_id = a7.user_id AND a7.login_date = d.login_date + INTERVAL '7 days'
LEFT JOIN daily_active a30
    ON d.user_id = a30.user_id AND a30.login_date = d.login_date + INTERVAL '30 days'
GROUP BY d.login_date;
该查询首先构建一个去重后的每日活跃用户视图`daily_active`,限定在一个时间范围内。然后,基于此视图进行三次自连接,分别匹配第1天、第7天和第30天的活跃记录。`SUM(CASE ...)`用于统计在每个时间点仍然活跃的用户数。最终结果按初始登录日期(`cohort_date`)分组,展示不同批次的用户在后续各天的留存绝对值和相对比例(需在外层或应用层计算比率)。这种方法避免了重复扫描大表,提高了效率。
当用户在同一天多次登录时如何处理数据偏差
当用户在同一天多次登录时,如果不进行去重处理,自连接会产生笛卡尔积效应,导致留存人数被严重高估。例如,如果一个用户在第一天登录了3次,第二天登录了2次,简单的自连接会匹配出6次记录,而不是1个留存用户。因此,必须在连接前或连接后对`user_id`和`date`的组合进行去重。
解决这一问题的关键在于确保参与连接的每一侧都是唯一的“用户-日期”对。在上述示例代码中,CTE `daily_active`使用了`DISTINCT user_id, login_date`,这保证了每个用户在每一天只出现一次。如果在原始表中存在大量重复日志,这一步骤至关重要。此外,在计算留存率时,使用`COUNT(DISTINCT user_id)`作为分母和分子中的计数依据,也能进一步防止因连接产生的冗余行影响统计结果。若不使用CTE去重,直接在主查询中使用`COUNT(DISTINCT curr.user_id)`和`COUNT(DISTINCT next.user_id)`也能达到类似效果,但性能可能略低,因为数据库需要先完成全连接再去重。推荐在连接前就清洗数据,确保输入数据的唯一性。