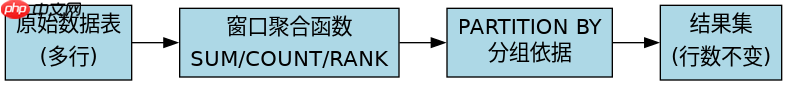
使用窗口聚合函数(如 sum()、count())配合 over (partition by ...) 子句,可以在保留原始行数据的同时计算分组统计值,从而避免 group by 导致的行数缩减和后续关联查询。只需在 select 列表中直接调用聚合函数并指定分区依据,即可一次性获取明细与汇总信息。
如何在不丢失明细行的情况下计算每组的累计总和
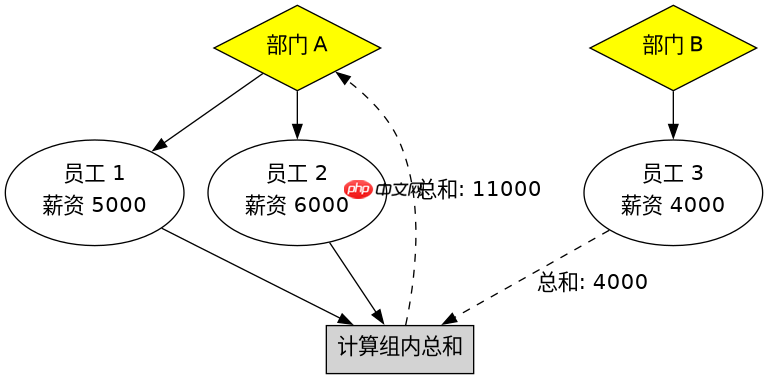
通过为窗口函数指定 PARTITION BY 子句,数据库会在每个分组内部独立进行聚合计算,同时保持查询结果集的行数与输入表一致。这意味着你可以直接在主查询中获取每一行的详细字段以及该行的所属分组的总计或累计值,无需再编写子查询或自连接来合并统计数据。
SELECT
    department,
    employee_name,
    salary,
    SUM(salary) OVER (PARTITION BY department) AS dept_total_salary
FROM employees;
预期结果:查询返回所有员工记录,其中 dept_total_salary 列显示其所在部门所有员工薪资的总和,行数未减少。
如何处理分组内的排序与排名需求
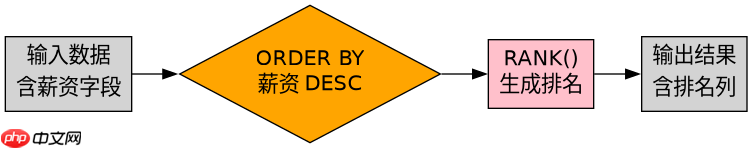
当需要在分组内基于特定列进行排序并生成排名时,可以使用 RANK() 或 DENSE_RANK() 等排名函数,并在 ORDER BY 子句中定义排序规则。这些函数同样受 PARTITION BY 控制,确保排名仅在各自分组内有效,且不会改变输出行的数量,非常适合用于提取每组的前 N 名记录。
SELECT
    department,
    employee_name,
    salary,
    RANK() OVER (
        PARTITION BY department
        ORDER BY salary DESC
    ) AS salary_rank
FROM employees;
预期结果:每个部门内的员工按薪资降序排列并获得相应的排名,相同薪资的员工获得相同排名,且中间名次会被跳过(RANK 行为),所有员工记录均保留在结果集中。
当某部门无员工数据时窗口函数会返回什么
如果查询的基础表中某个部门没有对应的员工记录,那么该部门根本不会出现在结果集中,因为窗口函数是基于现有行进行计算的,它不会凭空生成不存在的分组行。若需包含空部门,必须依赖外部维表进行 LEFT JOIN,此时窗口函数仅对 JOIN 后产生的实际数据行生效,对于 NULL 值的处理遵循标准 SQL 聚合逻辑,即忽略 NULL 参与计算。