








为什么SQL多维分析中CUBE比ROLLUP耗时更多
cube比rollup耗时更多是因为它生成的聚合组数量呈指数级增长,而rollup仅生成线性增长的层级组。具体做法是理解两者在grouping sets中的定义差异:cube生成所有可能的列组合,rollup只生成从全列到空的层级组合。这导致cube的计算量远大于rollup。
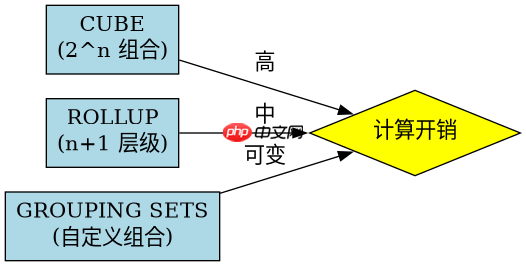
不同维度组合下的执行计划差异
在执行计划中,CUBE会产生更多的哈希聚合或排序操作节点,因为需要处理更多的分组键组合。相比之下,ROLLUP可以利用层级关系进行增量聚合,减少中间结果集的大小。通过对比EXPLAIN输出,可以清晰看到CUBE的并行度和内存消耗更高。
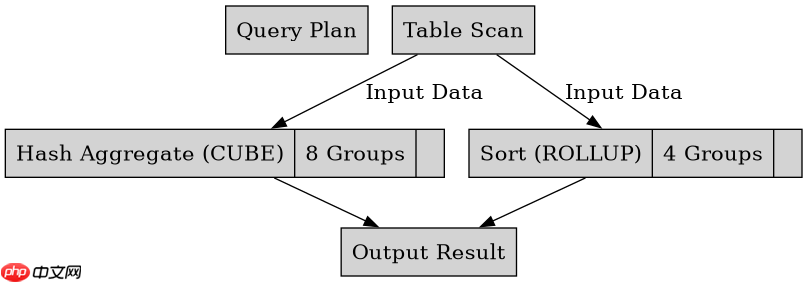
基于特定输入数据量的性能瓶颈分析
当输入数据量较大时,CUBE的笛卡尔积效应会导致内存溢出或磁盘交换,显著增加耗时。例如,对三个维度进行CUBE聚合,会生成8个分组,而ROLLUP仅生成4个。这种差异在大数据量下被放大,成为主要瓶颈。
digraph G { rankdir=LR; node [shape=box, style=filled, fillcolor=lightblue, fontsize=16]; edge [fontsize=16]; CUBE [label="CUBE\n(2^n 组合)"]; ROLLUP [label="ROLLUP\n(n+1 层级)"]; GROUPING_SETS [label="GROUPING SETS\n(自定义组合)"]; CUBE -> "计算开销" [label="高"]; ROLLUP -> "计算开销" [label="中"]; GROUPING_SETS -> "计算开销" [label="可变"]; "计算开销" [shape=diamond, style=filled, fillcolor=yellow]; } -- 图2 DOT -- digraph G { rankdir=TB; node [shape=record, style=filled, fontsize=16]; edge [fontsize=16]; Query [label="Query Plan"]; HashAggregate_Cube [label="Hash Aggregate (CUBE)\n|8 Groups|"]; Sort_Rollup [label="Sort (ROLLUP)\n|4 Groups|"]; Scan [label="Table Scan"]; Scan -> HashAggregate_Cube [label="Input Data"]; Scan -> Sort_Rollup [label="Input Data"]; HashAggregate_Cube -> "Output Result"; Sort_Rollup -> "Output Result"; } -- 图3 DOT -- digraph G { rankdir=LR; node [shape=box, style=filled, fontsize=16]; edge [fontsize=16]; SmallData [label="Small Data\n(Low Overhead)"]; LargeData [label="Large Data\n(High Overhead)"]; Memory [label="Memory Usage"]; DiskIO [label="Disk I/O"]; SmallData -> Memory [label="Minimal"]; LargeData -> Memory [label="High"]; LargeData -> DiskIO [label="Swap"]; DiskIO -> "Increased Latency" [label="Significant Delay"]; }















