








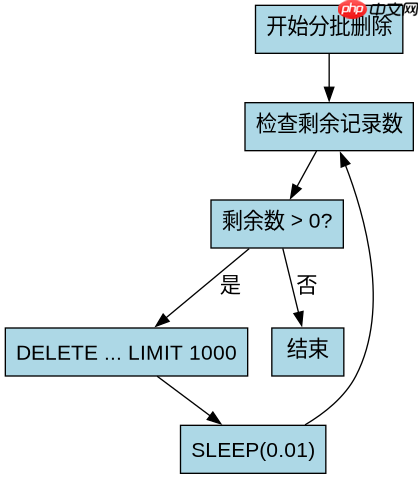
分批删除千万级大表的核心做法是:在循环中每次只删除固定数量(如1000行)的记录,并在每批之间插入短暂休眠以释放锁资源。具体实现时,需使用`limit`子句限制单次删除行数,配合事务控制确保原子性,并通过检查受影响行数判断是否还有剩余数据。这样既能避免长事务导致的锁死和主从延迟,又能保证业务在高并发下的可用性。
如何确定单批删除的最佳行数与间隔时间
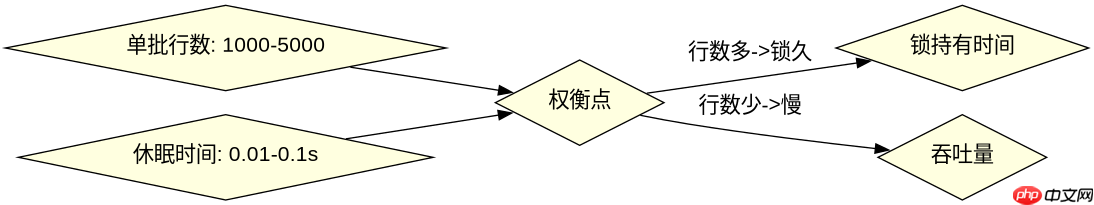
单批删除的行数通常设置为1000到5000之间,休眠时间建议设为0.01到0.1秒。行数过多会导致单批事务过大,占用undo log空间并延长锁持有时间;行数过少则增加循环次数,提升总耗时。休眠时间的目的是让其他查询或写入操作有机会获取锁,减少锁竞争。实际参数需根据表大小、索引情况和服务器负载微调。
DELIMITER //
CREATE PROCEDURE batch_delete_large_table()
BEGIN
    DECLARE done INT DEFAULT FALSE;
    DECLARE rows_affected INT;

    -- 定义游标用于检测是否有更多数据
    -- 这里简化为直接循环,实际可用while循环配合count
    WHILE (SELECT COUNT(*) FROM large_table WHERE status = 'pending') > 0 DO
        DELETE FROM large_table
        WHERE status = 'pending'
        LIMIT 1000;

        SET rows_affected = ROW_COUNT();

        -- 如果删除了0行,说明没有更多数据,退出循环
        IF rows_affected = 0 THEN
            LEAVE; -- 注意:在存储过程中需用标签跳出循环
        END IF;

        -- 休眠10毫秒,释放锁资源
        DO SLEEP(0.01);
    END WHILE;
END //
DELIMITER ;

-- 调用存储过程
CALL batch_delete_large_table();
上述代码演示了MySQL中的分批删除逻辑。首先通过`COUNT(*)`检查剩余待删除记录数,若大于0则进入循环。每次执行`DELETE ... LIMIT 1000`,利用`ROW_COUNT()`获取实际删除行数。若返回0,说明无更多匹配记录,终止循环。`SLEEP(0.01)`在每批后暂停,降低锁冲突概率。该过程需在事务外执行,或每批独立提交,以避免长事务累积undo日志。运行此程序后,`large_table`中所有`status='pending'`的记录将被逐步清除,且不会阻塞其他DML操作。
如何处理主键连续性与碎片整理
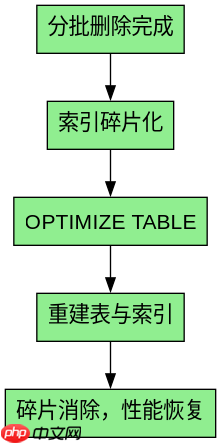
分批删除后,表中会产生大量空洞的主键值,导致索引碎片化,影响后续查询性能。建议在批量删除完成后,执行`OPTIMIZE TABLE`命令重建表结构,压缩碎片并重新排列物理存储。该操作会锁定表,因此应在业务低峰期执行。对于InnoDB引擎,也可考虑使用`ALTER TABLE ... ENGINE=InnoDB`进行在线重建,但需注意其对磁盘空间和临时文件的需求。
-- 假设已执行完batch_delete_large_table()存储过程
-- 检查表状态
SHOW TABLE STATUS LIKE 'large_table';

-- 执行优化,重建表和索引
OPTIMIZE TABLE large_table;
在分批删除完成后,`large_table`中可能存在大量未使用的页和碎片化的B+树索引。`OPTIMIZE TABLE`会复制原表到新表,重建索引,然后替换旧表,从而消除碎片。执行前建议备份表,因为该操作期间表不可写。对于超大表,可分阶段执行:先删除数据,再在非高峰时段优化。此步骤确保表空间高效利用,并维持查询性能稳定。
基于程序中LIMIT 1000的具体问题:若某批删除0行会怎样
当某批删除返回0行时,意味着当前条件下无更多匹配记录,程序应终止循环以避免无效重试。在提供的存储过程中,通过`ROW_COUNT()`检查返回值,若为0则跳出循环。这防止了无限循环和资源浪费。实际应用中,还需考虑并发场景下其他会话可能同时删除数据,导致本批预期有数据却实际为空,此时应结合`SLEEP`和重试机制或改用游标逐行处理以确保完整性。

















