








在hive sql中配置窗口帧范围以提高累计计算效率,核心做法是将默认的 range 模式显式切换为 rows 模式。默认情况下,hive 的 rows between unbounded preceding and current row 与 range between unbounded preceding and current row 在数据无重复时行为一致,但当存在重复键值时,range 会包含所有等于当前行的记录,导致计算结果偏离预期且性能开销更大。通过指定 rows,数据库仅基于物理行号进行滑动,避免了额外的排序和去重比较逻辑,从而显著提升处理速度。

如何避免 RANGE 模式导致的重复行计算错误
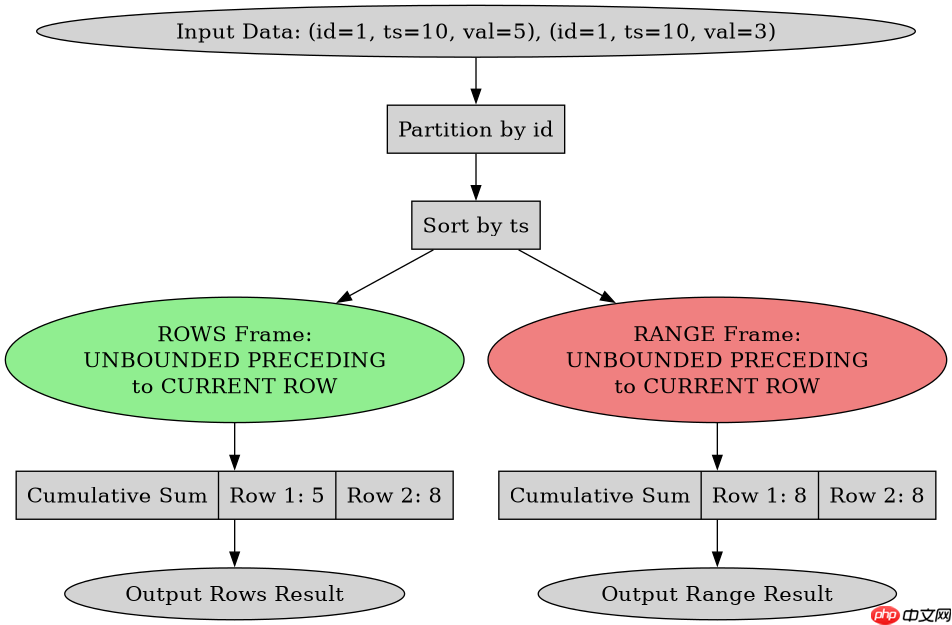
当使用 RANGE 作为窗口帧边界时,如果分区内存在相同的排序键值,窗口会扩展至包含所有具有相同值的行。例如,在按时间戳排序时,若多条记录拥有完全相同的时间戳,RANGE 会将它们全部纳入累计范围,导致计数或求和结果异常膨胀。相比之下,ROWS 严格依据物理行位置界定窗口,确保每行只被计算一次,符合大多数业务场景下的“逐行累加”直觉。
SELECT
    id,
    ts,
    value,
    SUM(value) OVER (
        PARTITION BY id
        ORDER BY ts
        ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
    ) AS cumulative_sum_rows,
    SUM(value) OVER (
        PARTITION BY id
        ORDER BY ts
        RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
    ) AS cumulative_sum_range
FROM transactions;
上述代码展示了两种模式的对比。假设输入数据中某 id 下有两行具有相同的 ts,cumulative_sum_rows 将分别计算前两行和前四行的累加值(假设中间有其他行),而 cumulative_sum_range 会在遇到第二个相同时间戳时,将之前所有相同时间戳的行都计入总和。对于需要精确逐行累计的场景,必须使用 ROWS。
如何通过 ROWS 模式优化大数据量下的执行计划
在大数据集上,RANGE 模式要求 Hive 在执行窗口函数前对数据进行更复杂的分组和相等性检查,这往往触发额外的 Shuffle 或 Sort 操作。切换到 ROWS 模式后,引擎可以简单地维护一个滑动指针,无需频繁比较键值是否相等。这种优化在处理数百万行数据时尤为明显,能减少内存占用并加快任务完成时间。建议在所有不需要基于值相等性扩展窗口的场景中,强制使用 ROWS。

-- 优化后的查询示例
SELECT
    user_id,
    event_time,
    amount,
    SUM(amount) OVER (
        PARTITION BY user_id
        ORDER BY event_time
        ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
    ) AS running_total
FROM user_events
WHERE event_date = '2023-10-01';
该查询针对特定日期的用户事件进行累计求和。由于 event_time 通常具有唯一性或业务上允许逐行处理,使用 ROWS 不仅保证了结果的准确性,还避免了因时间戳精度问题导致的意外聚合。在实际生产环境中,将此模式作为默认选择可提升整体作业稳定性。
当输入数据包含空值时窗口帧如何处理
在窗口计算中,如果排序列 ORDER BY 中包含 NULL 值,Hive 会根据 NULLS FIRST 或 NULLS LAST 子句决定其位置。无论采用 ROWS 还是 RANGE,NULL 值都会被视为独立的排序键。在使用 ROWS 时,NULL 行会被正常纳入累计过程,其前后的行不受影响。若未指定 NULLS 子句,Hive 默认将 NULL 排在前面。开发者应明确指定排序规则,以避免因隐式排序导致累计顺序不符合业务逻辑。


















