








使用视图替代大宽表的核心做法是:将分散在多个基础表中的字段通过join操作动态组合,并在查询时按需加载,从而避免物理存储冗余。具体实现需定义包含必要join条件的create view语句,并配合物化视图或分区策略优化性能。此方法显著降低存储占用,但可能增加查询时的计算开销。
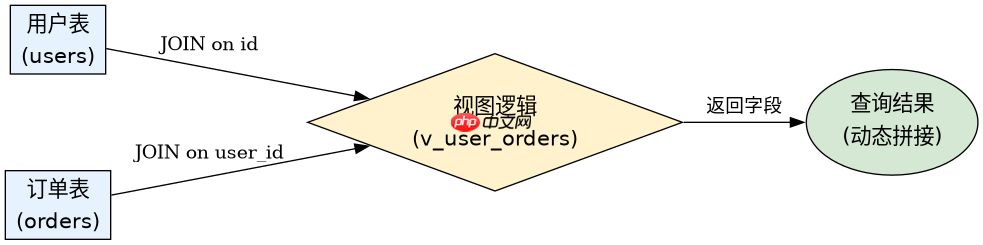
如何定义支持多表关联的视图结构
定义视图时需明确指定基础表和连接条件,确保逻辑正确性。例如,创建用户订单视图需关联用户表与订单表,并通过主外键匹配数据。该结构允许后续查询直接引用视图名,无需重复编写JOIN逻辑。
CREATE VIEW v_user_orders AS
SELECT u.id, u.name, o.order_id, o.amount
FROM users u
JOIN orders o ON u.id = o.user_id;
上述代码创建了名为v_user_orders的视图,其结果集包含用户ID、姓名及对应订单信息。执行SELECT * FROM v_user_orders可获取动态拼接的数据,原始users和orders表仅存储各自独立记录,无冗余字段。
如何通过索引优化视图查询性能
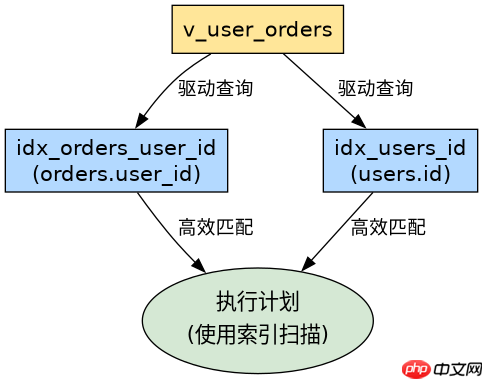
视图本身不存储数据,因此查询性能依赖底层表的索引设计。为提升JOIN效率,应在关联字段(如user_id)上建立索引。若频繁访问特定字段组合,可考虑部分列索引或覆盖索引以减少回表操作。
CREATE INDEX idx_orders_user_id ON orders(user_id);
CREATE INDEX idx_users_id ON users(id);
添加索引后,视图查询的执行计划将优先使用索引扫描而非全表扫描。验证方式:EXPLAIN SELECT * FROM v_user_orders WHERE user_id = 100; 观察type是否为ref或eq_ref,且key指向idx_orders_user_id。未加索引时,JOIN操作可能导致笛卡尔积式扫描,性能急剧下降。
当视图涉及聚合函数时如何处理存储节省问题
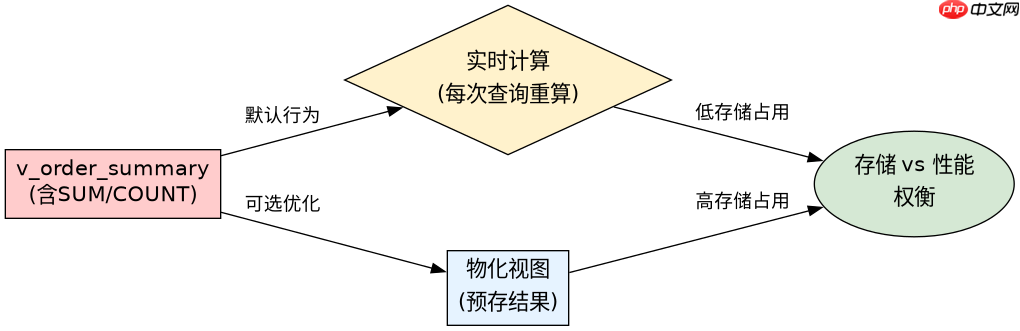
若视图包含SUM、COUNT等聚合操作,需注意每次查询都会重新计算,无法像物化视图那样预存结果。此时应评估数据更新频率:若基础表极少变更,可改用物化视图定期刷新;若实时性要求高,则接受计算开销以换取存储精简。示例中v_order_summary每日汇总订单总额,若改为物化视图需额外存储空间,但查询速度更快。


















