








如何使用 ROW_NUMBER 保留重复数据的最后一条
在 sql 中,使用 row_number() 窗口函数配合 over (partition by ... order by ...) 可以高效地处理重复数据。要实现保留每组重复记录中的“最后一条”,核心做法是:按分组列分区,并按时间或自增 id 等表示顺序的列进行降序(desc)排序,然后筛选出序号为 1 的记录。

具体实现步骤与代码示例
直接回答本节问题:你需要先确定哪几列构成“重复”的定义(即分区键),以及哪一列代表“最后”的时间或顺序(即排序键)。假设我们有一张日志表 logs,包含 user_id、action 和 created_at。我们要保留每个用户最后一次操作记录。
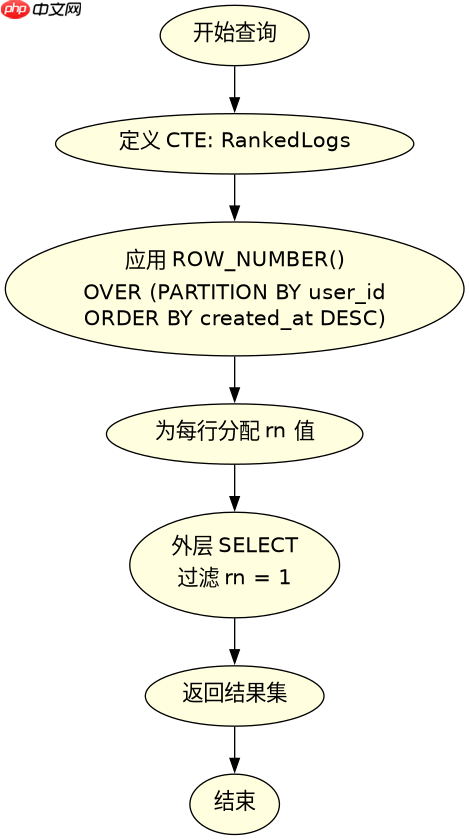
WITH RankedLogs AS (SELECT *, ROW_NUMBER() OVER (PARTITION BY user_id ORDER BY created_at DESC) as rnFROM logs)SELECT user_id, action, created_atFROM RankedLogsWHERE rn = 1;
上述查询首先通过 CTE 计算每行在各自 user_id 组内的排名。由于 ORDER BY created_at DESC,最新时间的记录会被赋予 rn = 1。外层查询仅选取 rn = 1 的行,从而得到每个用户的最后一条操作。如果存在多条完全相同的记录且需要去重,可结合 DISTINCT 或在排序时增加次要排序键以确保确定性。
基于特定输入条件的结果验证
针对上述程序,当输入数据中存在同一用户在同一天多次操作的情况时,ROW_NUMBER() 会依据 created_at 的精确到秒(或更小单位)的值进行排序。若 created_at 完全相同,数据库可能任意选择其中一条作为“最后一条”,这取决于底层存储引擎的实现。为确保结果稳定,建议在 ORDER BY 子句中追加主键 ID 作为第二排序条件,例如 ORDER BY created_at DESC, id DESC。这样即使时间戳相同,ID 最大的那条记录也会被明确选为最后一条,保证每次运行结果一致。


















