








统筹设计跨数据源联合查询的防注入机制,核心在于将sql拼接彻底剥离出业务逻辑,强制使用参数化查询(prepared statements)或orm映射,并在应用层建立统一的数据访问抽象。具体做法是定义一个通用的repository接口,针对每个数据源实现独立的dao层,所有查询条件必须通过占位符传入,严禁字符串拼接;同时利用连接池隔离不同数据源的会话,确保事务边界清晰且执行计划可预测。

如何构建统一的数据访问抽象层以屏蔽底层差异
构建统一抽象层的关键在于定义标准化的接口契约,使上层业务代码不感知具体使用的是MySQL、PostgreSQL还是MongoDB。通过依赖注入容器管理不同的DataSource实例,业务层仅调用统一的Service方法,从而在编译期就杜绝了硬编码SQL语句的可能性。这种设计不仅解决了多数据源切换的问题,还天然地限制了直接操作数据库底层的权限,为后续的安全审计提供了单一入口。
import javax.sql.DataSource;
import java.sql.Connection;
import java.sql.PreparedStatement;
import java.sql.ResultSet;
import java.util.ArrayList;
import java.util.List;

public class UnifiedQueryExecutor {
    private final DataSource primaryDs;
    private final DataSource secondaryDs;

    public UnifiedQueryExecutor(DataSource primary, DataSource secondary) {
        this.primaryDs = primary;
        this.secondaryDs = secondary;
    }

    // 统一查询入口,强制使用参数化
    public List<String> executeSafeQuery(String sql, Object... params) throws Exception {
        List<String> results = new ArrayList<>();
        // 模拟根据路由规则选择数据源
        try (Connection conn = primaryDs.getConnection();
             PreparedStatement pstmt = conn.prepareStatement(sql)) {

            for (int i = 0; i < params.length; i++) {
                pstmt.setObject(i + 1, params[i]);
            }

            try (ResultSet rs = pstmt.executeQuery()) {
                while (rs.next()) {
                    results.add(rs.getString(1));
                }
            }
        }
        return results;
    }
}
跨库Join场景下的事务与性能隔离策略
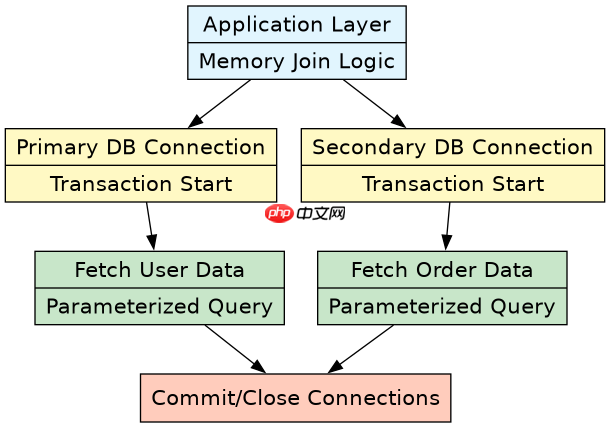
在涉及跨库Join时,由于传统关系型数据库不支持分布式事务的原子性Join,通常需要在应用层进行“拉取-过滤”或“广播-关联”。为了防止注入,必须确保从两个数据源获取的数据在内存中进行关联时,不再拼接任何新的SQL片段。推荐使用本地事务管理每个数据源的读取操作,并通过设置隔离级别避免脏读。对于高频查询,应引入缓存层拦截重复请求,减少直连数据库的压力,同时在缓存Key生成时使用哈希算法而非原始输入值,防止缓存投毒。
import org.springframework.stereotype.Service;
import java.util.HashMap;
import java.util.Map;

@Service
public class CrossDataSourceService {
    private final UnifiedQueryExecutor executor;

    public CrossDataSourceService(UnifiedQueryExecutor executor) {
        this.executor = executor;
    }

    public Map<String, Object> getAggregatedData(String userId) {
        // 1. 安全获取主库用户信息
        String userSql = "SELECT name, email FROM users WHERE id = ?";
        List<String> userData = executor.executeSafeQuery(userSql, userId);

        // 2. 安全获取辅库订单信息
        String orderSql = "SELECT order_id, amount FROM orders WHERE user_id = ?";
        List<String> orderData = executor.executeSafeQuery(orderSql, userId);

        // 3. 在应用层组装结果,严禁在此处拼接SQL
        Map<String, Object> result = new HashMap<>();
        if (!userData.isEmpty()) {
            result.put("user", userData.get(0));
        }
        result.put("orders", orderData);
        return result;
    }
}
如何处理动态排序字段带来的注入风险
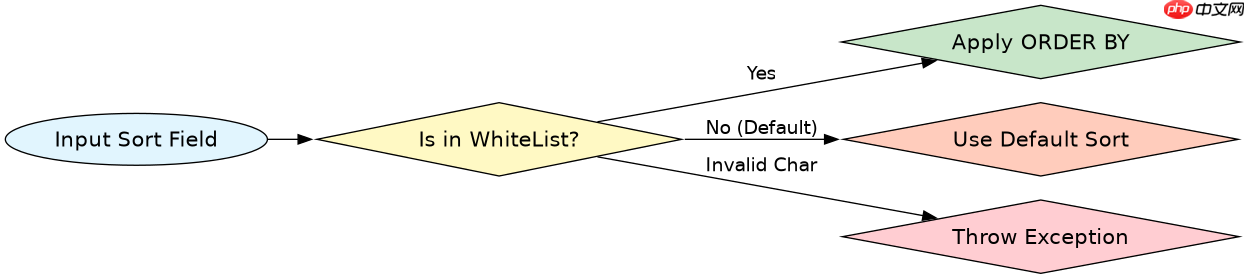
当用户需要自定义排序字段(如ORDER BY)时,由于列名无法通过预编译语句的参数化方式传入,极易成为注入点。解决该问题的唯一可靠方法是白名单校验机制。在接收到排序参数后,程序需将其与数据库中实际存在的列名列表进行比对,若不在白名单内则拒绝执行或回退到默认排序。此外,还应限制排序字段的数量,防止通过超长字符串导致解析错误或资源耗尽。这种校验必须在进入DAO层之前完成,确保没有任何未经净化的标识符能到达数据库驱动层。


















