








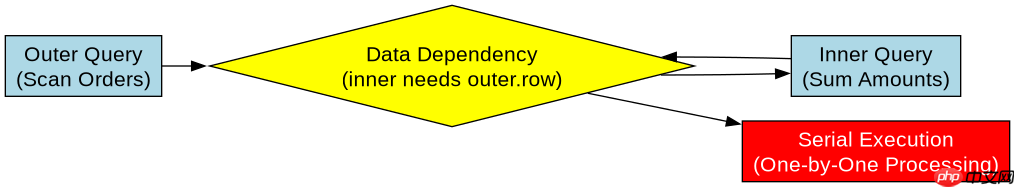
sql中关联子查询无法并行执行的核心原因是数据依赖:内层查询的执行依赖于外层查询当前行的值,这种逐行处理的逻辑强制了串行顺序。要解决或规避这个问题,通常的做法是将关联子查询重写为join操作或使用窗口函数,从而将数据访问转化为可并行的集合操作。如果必须保留子查询结构,需确保内层查询不引用外层表的列,或者使用数据库特定的hint(如oracle的parallel)尝试强制并行,但效果取决于优化器的判断。
为什么关联子查询会阻塞并行处理
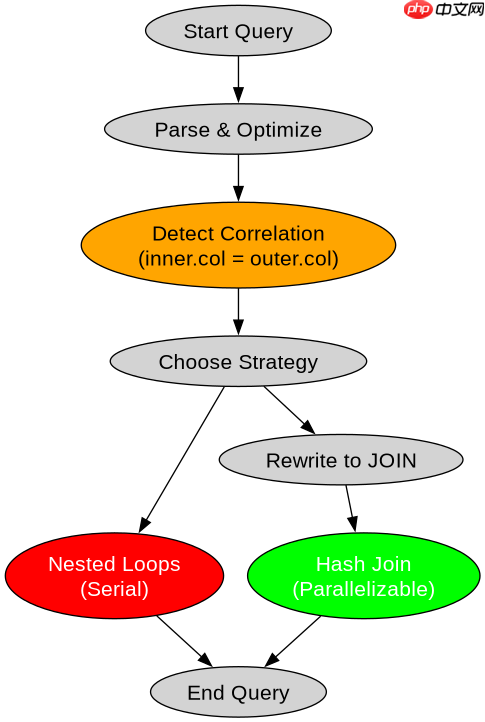
关联子查询之所以难以并行,是因为它引入了行级依赖。在执行计划中,内层查询往往被标记为NESTED LOOPS,这意味着对于外层查询的每一行结果,数据库都必须重新执行一次内层查询。这种“驱动表-探测表”的模式天然适合串行执行,因为内层的输入流是动态生成的,无法像静态表扫描那样预先分割成多个独立的数据块分发给不同的CPU核心。例如,当内层查询包含`WHERE inner.col = outer.col`时,优化器无法在启动并行扫描前确定内层需要处理哪些数据范围,因此被迫退化为串行执行以维护数据一致性。
SELECT o.order_id,
       (SELECT SUM(i.amount)
        FROM order_items i
        WHERE i.order_id = o.order_id) as total_amount
FROM orders o;
上述代码中,`order_items`表的扫描依赖于`orders`表的每一行。如果`orders`有10万行,`order_items`就需要被扫描10万次。在并行环境下,这会导致严重的资源争用和锁竞争,因为多个并行进程可能同时尝试访问同一批索引页。相比之下,如果使用JOIN写法:
SELECT o.order_id, SUM(i.amount) as total_amount
FROM orders o
JOIN order_items i ON o.order_id = i.order_id
GROUP BY o.order_id;
优化器可以将`orders`和`order_items`都进行并行哈希连接(Hash Join),将数据分区后分别计算局部聚合,最后再合并结果。这种模式允许数据库利用多核优势,显著降低执行时间。验证这一点的最佳方式是查看执行计划中的`Operation`列,关联子查询通常显示为`SUBQUERY`或`NESTED LOOPS`,而改写后的JOIN则可能显示为`HASH JOIN`或`MERGE JOIN`,且并行度(Degree of Parallelism)会显著提升。
如何识别并改写不可并行的子查询
识别不可并行的子查询主要依靠分析执行计划中的操作符类型和依赖关系。在MySQL 8.0+或PostgreSQL中,可以使用`EXPLAIN ANALYZE`来观察实际执行路径。如果看到`Dependent Subquery`或`Nested Loop`且内层操作频繁重复执行,即为典型瓶颈。改写的核心策略是消除相关性,即将“每行执行一次”的逻辑转化为“一次性集合运算”。除了前述的JOIN改写外,还可以使用CTE(公共表表达式)预计算中间结果,或者使用LATERAL JOIN(在某些数据库中支持并行化LATERAL源)。
另一个常见的场景是相关子查询用于过滤条件,如`WHERE EXISTS (...)`。这类查询同样存在依赖问题。例如:
SELECT * FROM customers c
WHERE EXISTS (
    SELECT 1 FROM orders o
    WHERE o.customer_id = c.id AND o.amount > 1000
);
此查询对每个客户都要检查订单表。改写为JOIN或IN子句(视优化器能力而定):
SELECT DISTINCT c.* FROM customers c
JOIN orders o ON c.id = o.customer_id
WHERE o.amount > 1000;
注意,这里使用了`DISTINCT`来模拟`EXISTS`的去重语义。在某些数据库中,`IN`子句可能被优化为Anti-Join或Semi-Join,这些操作符在现代优化器中更容易被并行化。关键在于,改写后的查询不再要求内层查询随外层行变化而重新初始化,而是可以构建一个固定的执行树,从而允许并行扫描和并行聚合。
为了验证改写效果,可以对比两种写法的执行时间和资源消耗。在PostgreSQL中,可以通过设置`enable_seqscan=off`等参数强制使用索引,观察嵌套循环与哈希连接的性能差异。在Oracle中,可以使用`DBMS_XPLAN.DISPLAY_CURSOR`查看并行执行服务器(PX)的使用情况。如果关联子查询导致PX服务器闲置或负载不均,说明并行化失败。此外,监控`V$SESSION_LONGOPS`或`pg_stat_activity`可以帮助定位具体的耗时步骤。
特定条件下关联子查询能否被并行化
尽管关联子查询通常串行,但在某些特定条件下,现代数据库引擎可以尝试部分并行化。例如,如果内层查询是一个简单的聚合且不涉及复杂的排序或外部IO,优化器可能会采用“并行嵌套循环”策略,即外层查询并行扫描,每个并行线程独立执行内层查询。但这仅限于内层查询完全独立于其他外层行且无共享状态修改的情况。此外,如果数据库支持“并行子查询展开”(Subquery Unrolling),如Oracle在某些版本中对`IN`子查询的处理,可以将子查询转换为多个并行连接的分支。
然而,这种并行化是有代价的。它可能导致内存压力增大,因为每个并行线程都需要维护自己的执行上下文。如果内层查询返回大量数据,并行嵌套循环的性能可能反而低于串行执行,因为上下文切换和内存拷贝的开销超过了并行带来的收益。因此,大多数情况下,优化器默认选择串行执行关联子查询,除非通过Hint强制指定并行度,且数据量足够大以抵消固定开销。
在实际应用中,建议优先通过SQL重构来避免关联子查询,而不是依赖数据库的自动并行化能力。如果必须使用,应确保内层查询有合适的索引,以减少每次执行的I/O成本。例如,在上面的例子中,确保`order_items(order_id)`上有索引,可以大幅减少嵌套循环的总耗时,即使它是串行的。最终,判断是否可行的标准是执行计划的稳定性和资源利用率,而非单纯的语法正确性。


















