








在 postgresql 16 中,实现 select 查询不区分大小写最直接的方法是使用 ilike 操作符或 lower() 函数。使用 ilike 可以直接替代 like 进行模式匹配,无需修改数据;若需对列值进行统一比较,可结合 lower() 将输入与数据库内容同时转为小写处理。
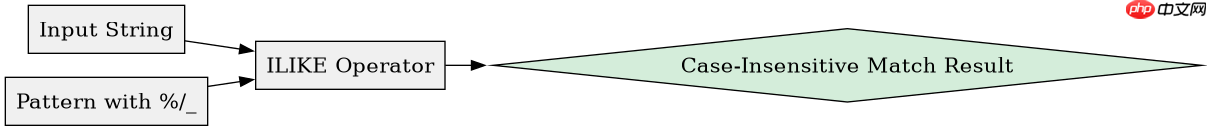
ILIKE 操作符的具体用法是什么
ILIKE 是 PostgreSQL 特有的操作符,用于执行不区分大小写的字符串模式匹配。它支持通配符 %(匹配任意字符序列)和 _(匹配单个字符),语法结构与 LIKE 完全一致,但忽略字母的大小写差异。

SELECT * FROM users WHERE username ILIKE 'Admin';
-- 结果:匹配 'admin', 'ADMIN', 'Admin', 'aDmIn' 等

SELECT * FROM users WHERE email ILIKE '%@example.com';
-- 结果:匹配所有域名部分为 example.com 的邮箱,无论大小写
上述代码展示了两种常见场景:精确匹配用户名变体和模糊匹配邮箱后缀。当使用 ILIKE 时,PostgreSQL 会根据当前会话的 LC_COLLATE 设置决定哪些字符被视为等价。在大多数 UTF-8 环境下,ASCII 字母的大小写映射是标准的,因此 'A' 与 'a' 被视为相同。
使用 LOWER() 函数的适用场景有哪些
当需要比较两个列的值,或者进行范围查询、排序时,ILIKE 无法直接使用,此时应使用 LOWER() 函数。该函数将字符串转换为小写形式,从而实现不区分大小写的比较逻辑。
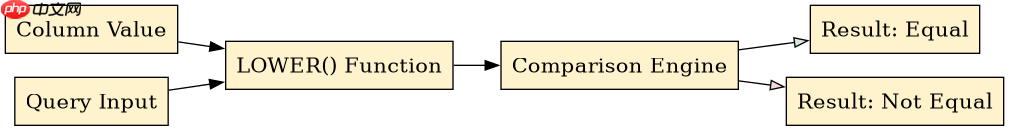
SELECT * FROM products WHERE LOWER(name) = LOWER('iPhone 15');
-- 结果:匹配 'iphone 15', 'IPHONE 15', 'Iphone 15' 等

SELECT * FROM orders WHERE LOWER(status) IN ('pending', 'shipped');
-- 结果:匹配状态为 pending 或 shipped 的记录,忽略大小写
此方法适用于等值比较和 IN 列表匹配。需要注意的是,LOWER() 不会改变原始数据,仅在查询时动态转换。如果频繁使用此方式,建议考虑在列上创建基于表达式的索引以优化性能。
在包含特殊字符的中文环境下 ILIKE 的行为如何
在 PostgreSQL 16 中,若数据库使用 C 或 C.UTF-8 以外的 LC_COLLATE 设置(如 zh_CN.UTF-8),ILIKE 的行为可能受 locale 影响。对于纯 ASCII 字符,行为通常稳定;但对于非 ASCII 字符(如中文、带音标的拉丁字母),大小写折叠规则取决于 locale 定义。
-- 假设表中有中文名称
SELECT * FROM items WHERE name ILIKE '苹果';
-- 在 zh_CN.UTF-8 下,'苹果' 与 '苹果'(若存在编码异常)可能不匹配
-- 但正常中文无大小写概念,故 ILIKE 对纯中文等同于 LIKE
中文本身没有大小写之分,因此 ILIKE 对纯中文文本的处理与 LIKE 相同。若混合中英文,例如 'Apple苹果',则英文部分仍遵循大小写不敏感规则,中文部分保持不变。建议在涉及多语言环境时,明确测试边界情况,并考虑使用 citext 扩展类型来统一管理大小写不敏感的字符串列。


















