








优化包含多个over子句的物理执行计划,核心在于减少窗口函数的计算开销并避免不必要的排序操作。可以通过合并具有相同partition by和order by子句的窗口定义来复用排序结果,或者使用cte(公共表表达式)将复杂的窗口逻辑分层处理,从而让优化器更清晰地识别执行步骤。此外,确保分区列和排序列上有合适的索引,可以显著降低数据在内存或磁盘上的重排成本。

如何识别重复的窗口定义以进行合并
当SQL查询中存在多个OVER子句且它们的PARTITION BY和ORDER BY完全一致时,数据库引擎通常会执行多次相同的排序操作,导致性能下降。识别这些重复项是优化的第一步,通过将这些窗口函数合并到一个单一的窗口定义中,可以大幅减少CPU和I/O开销。
SELECT
    id,
    department,
    salary,
    AVG(salary) OVER (PARTITION BY department ORDER BY hire_date) as avg_sal,
    SUM(salary) OVER (PARTITION BY department ORDER BY hire_date) as sum_sal
FROM employees;
上述查询中,两个窗口函数使用了相同的分区和排序键。优化后的写法是将它们合并,虽然语法上每个聚合仍需独立的OVER子句,但现代优化器(如PostgreSQL 14+或SQL Server)能自动检测并复用排序流。若手动优化,可考虑使用CTE预计算排序后的中间结果。
如何利用CTE分层简化复杂窗口逻辑
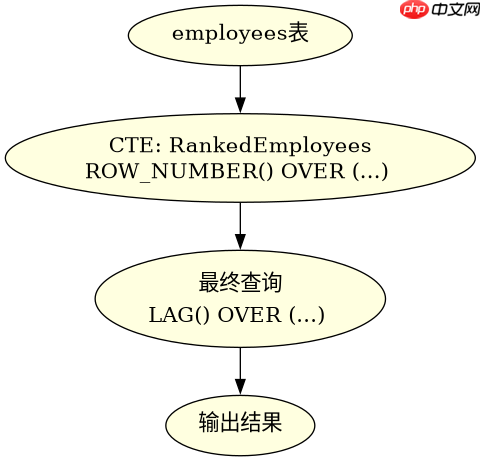
对于涉及多个不同窗口定义的复杂查询,使用CTE可以将逻辑分解为多个阶段。每一层CTE只负责一个特定的窗口计算,这样不仅提高了代码可读性,还允许优化器对每一层独立选择最佳执行策略,例如在第一层使用索引扫描,第二层使用哈希聚合。
WITH RankedEmployees AS (
    SELECT
        id,
        department,
        salary,
        ROW_NUMBER() OVER (PARTITION BY department ORDER BY salary DESC) as rn
    FROM employees
)
SELECT
    id,
    department,
    salary,
    LAG(salary) OVER (PARTITION BY department ORDER BY salary) as prev_sal
FROM RankedEmployees
WHERE rn <= 10;
在这个例子中,第一层CTE计算了排名,第二层查询在此基础上计算滞后值。这种分层结构避免了在一个大查询中混合多种窗口逻辑,使得执行计划更加清晰。注意,如果第二层的窗口定义与第一层不同,数据库可能需要重新排序,因此应尽量减少跨层的依赖。
特定输入下窗口函数导致的排序瓶颈分析
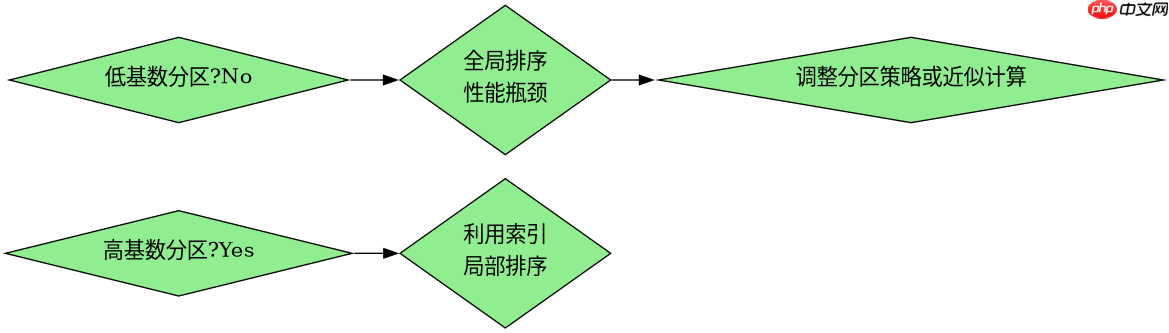
当输入数据量极大且分区列选择性低时,窗口函数的排序操作会成为主要瓶颈。例如,如果所有记录都属于同一个分区,那么ORDER BY子句将导致全局排序,这在分布式数据库中尤为昂贵。此时,可以考虑调整分区策略或使用近似算法来缓解压力。














