








使用 readfile() 配合 set_time_limit(0) 可以解决大文件下载超时问题。核心做法是在输出文件内容前调用该函数关闭执行时间限制,并设置正确的 http 响应头(如 content-type 和 content-disposition),确保浏览器能识别为附件下载而非直接预览。

set_time_limit(0) 对 PHP-FPM 的生效范围是什么
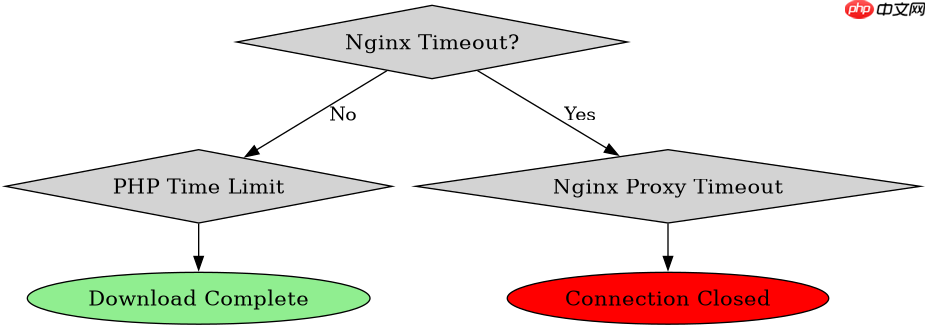
在 CLI 模式下 set_time_limit(0) 无效,但在 Web 服务器(如 Nginx + PHP-FPM)环境中,它仅影响当前 PHP 脚本的执行时间,不影响 Nginx 的代理超时设置。若 Nginx 配置了较短的 proxy_read_timeout,即使 PHP 不超时,连接仍会被切断。因此必须同时调整 Web 服务器层的超时参数,确保其与文件传输时长匹配。
<?php
$file = '/path/to/large/file.zip';
if (file_exists($file)) {
    // 关闭 PHP 执行超时限制
    set_time_limit(0);

    header('Content-Description: File Transfer');
    header('Content-Type: application/octet-stream');
    header('Content-Disposition: attachment; filename="' . basename($file) . '"');
    header('Expires: 0');
    header('Cache-Control: must-revalidate');
    header('Pragma: public');
    header('Content-Length: ' . filesize($file));

    // 清除输出缓冲,避免内存溢出
    if (ob_get_level()) ob_end_clean();

    readfile($file);
    exit;
}
?>
上述代码中,set_time_limit(0) 是关键步骤。当文件较大时,readfile() 会逐块读取并输出,若未关闭超时,PHP 会在默认 30 秒后终止脚本,导致下载中断。配合 header 设置,可确保客户端正确接收二进制流。
立即学习“PHP免费学习笔记(深入)”;

如何验证大文件下载的完整性与断点续传支持
标准 readfile() 实现不支持断点续传,因为未处理 Range 请求头。若需支持断点续传,需解析 HTTP_RANGE 头,计算偏移量,并使用 fopen() 定位文件指针后分块输出。对于超大文件,建议结合 seek() 和循环读取,以节省内存并允许客户端恢复下载。

<?php
$file = '/path/to/large/file.zip';
$size = filesize($file);
$start = 0;
$end = $size - 1;

// 检查 Range 头
if (isset($_SERVER['HTTP_RANGE'])) {
    preg_match('/^bytes=(\d+)-(\d*)$/', $_SERVER['HTTP_RANGE'], $matches);
    $start = intval($matches[1]);
    $end = $matches[2] ? intval($matches[2]) : $size - 1;

    header('HTTP/1.1 206 Partial Content');
    header('Content-Range: bytes ' . $start . '-' . $end . '/' . $size);
    header('Content-Length: ' . ($end - $start + 1));
} else {
    header('Content-Length: ' . $size);
}

header('Accept-Ranges: bytes');
header('Content-Type: application/octet-stream');
header('Content-Disposition: attachment; filename="' . basename($file) . '"');

$f = fopen($file, 'rb');
fseek($f, $start);
while (!feof($f) && ftell($f) <= $end) {
    echo fread($f, 8192);
    flush();
}
fclose($f);
?>
此版本通过解析 HTTP_RANGE 头,实现了对断点续传的支持。当客户端请求部分字节时,服务器返回 206 状态码及对应的 Content-Range,从而允许下载中断后继续。注意:若无需断点续传,应使用前一节的简单实现,因其更稳定且资源占用更低。
基于 readfile() 输出时的内存占用情况
readfile() 内部使用缓冲区逐块读取文件,不会将整个文件加载到内存中,因此内存占用恒定且较低。相比之下,若使用 file_get_contents() 一次性读取,大文件会导致内存耗尽。因此,在处理 GB 级文件时,必须使用 readfile() 或类似流式输出方法,以避免 Fatal error: Allowed memory size exhausted 错误。



















