








在分组统计场景中,使用sql取余比php取余更合适。因为数据库引擎在处理数据聚合和过滤时具有底层优化优势,能够减少网络传输开销并降低应用服务器的内存压力。具体做法是在sql查询中使用`mod()`函数或`%`运算符进行条件筛选,直接返回符合特定余数条件的记录,避免将全量数据拉取到php中进行二次处理。

为什么SQL取余优于PHP取余
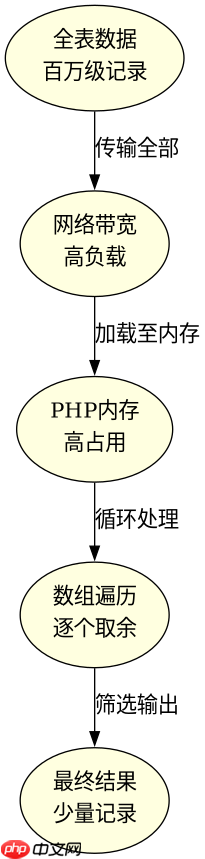
SQL取余的核心优势在于执行效率与资源隔离。当数据量较大时,如果在PHP中处理,需要先通过`SELECT *`获取所有相关行,然后在内存中遍历数组计算取余,这不仅消耗大量带宽,还可能导致PHP进程内存溢出。而在SQL中直接计算,数据库可以利用索引(如果存在相关列)或高效的扫描算法,仅将满足条件的少量结果集返回给应用层。这种“推”模式比PHP的“拉”模式更符合大数据处理的最佳实践。
SELECT id, category, value FROM stats_table WHERE MOD(category_id, 3) = 0;
上述SQL语句展示了如何在MySQL中直接筛选出`category_id`能被3整除的记录。假设`stats_table`中有百万级数据,该查询会直接在存储引擎层完成过滤,仅返回约三分之一的数据。相比之下,若用PHP实现,需先执行`SELECT id, category, value FROM stats_table`,然后在PHP代码中循环判断`$row['category_id'] % 3 == 0`,这将导致不必要的全表数据传输和处理延迟。
立即学习“PHP免费学习笔记(深入)”;

何时需要在PHP中进行取余处理
尽管SQL取余在大多数统计场景下更优,但在某些特定逻辑下,PHP取余是必要或更合适的选择。例如,当取余的逻辑依赖于跨表关联后的复杂业务规则,或者需要结合非结构化数据(如JSON字段解析后的值)进行判断时,SQL可能无法直接表达该逻辑。此外,如果取余操作涉及动态生成的余数条件(如根据用户配置实时变化的模数),且该条件无法预先写入静态SQL参数化查询中,则在PHP中构建查询条件或后处理数据更为灵活。
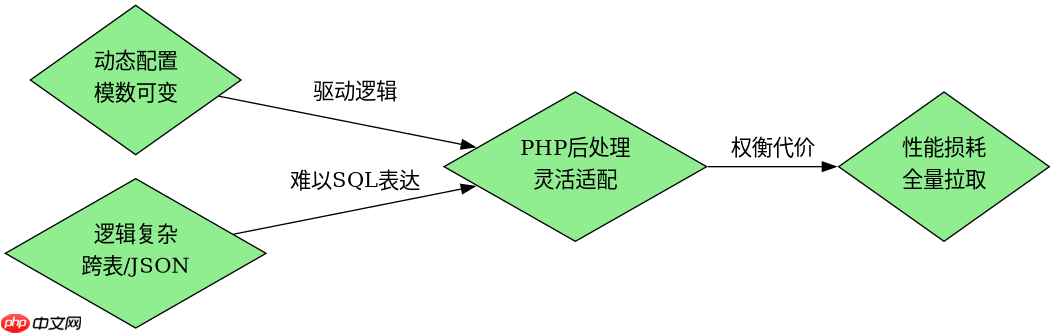
$dynamicMod = getUserConfiguredMod(); // 假设从配置获取 $results = []; foreach ($db->fetchAll('SELECT id, val FROM data') as $row) { if ($row['val'] % $dynamicMod === 0) { $results[] = $row; } }这段PHP代码演示了动态取余的场景。由于`$dynamicMod`的值在运行时才确定,且可能影响整个业务逻辑流,直接在SQL中硬编码或使用预编译参数可能不够灵活(尤其是当逻辑复杂到无法简单转化为WHERE子句时)。此时,PHP作为应用层控制器,负责协调动态配置与数据过滤,虽然牺牲了部分性能,但换取了逻辑的可变性和扩展性。注意,此方法仅适用于数据量较小或已预先分页/限制的结果集,否则应优先考虑将动态条件传入SQL。
基于程序中某个输入、条件或结果的具体问题
在实际开发中,一个常见的问题是:当SQL取余操作应用于负数或零值时,结果是否符合预期?例如,`MOD(-5, 3)`在MySQL中返回`-2`,而在某些其他数据库或PHP中可能返回`1`。这种差异会导致分组统计结果不一致。因此,在使用SQL取余前,必须确认目标数据库对负数取余的行为,并在必要时使用`ABS()`或条件判断进行标准化,以确保统计结果的准确性。若使用PHP取余,则需注意PHP的`%`运算符对负数的处理规则(保留被除数的符号),并与SQL行为对齐,避免数据偏差。

















