








按ID取余做分表,扩容后数据该怎么迁移?
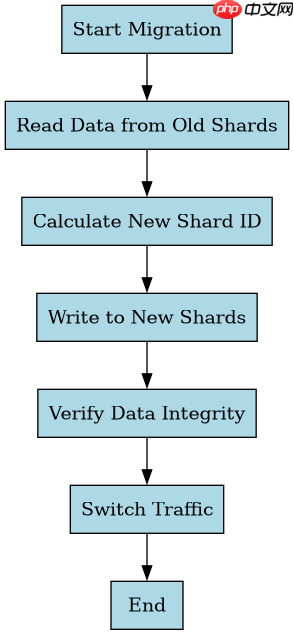
使用一致性哈希或重新计算取模值进行全量重分布。具体做法是读取所有旧表数据,根据新分表数量重新计算目标分表位置,将数据写入新库并校验完整性,最后切换流量。
如何保证迁移过程中的数据一致性?
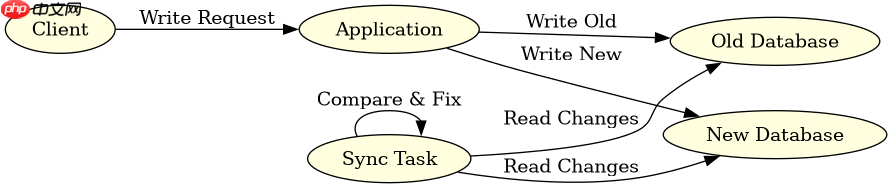
采用双写机制和增量同步来确保数据不丢失。在迁移期间,业务代码同时向旧表和新表写入,后台任务持续比对差异并修复不一致记录,直到数据完全对齐后再停止对旧表的写入。
迁移完成后如何验证数据完整性?
通过抽样比对和总量核对来验证结果。检查新旧库中特定ID范围的数据是否一致,确认总记录数是否匹配,并确保没有重复或遗漏的记录,从而保证迁移成功。
    graph TD
        A[开始迁移] --> B[读取旧表数据]
        B --> C[计算新分表位置]
        C --> D[写入新库]
        D --> E[校验数据]
        E --> F{校验通过?}
        F -- 是 --> G[切换流量]
        F -- 否 --> H[修复数据]
        H --> D
        G --> I[结束]
    sequenceDiagram
        participant Client
        participant App
        participant OldDB
        participant NewDB
        participant SyncTask
        Client->>App: 请求写入
        App->>OldDB: 写入旧表
        App->>NewDB: 写入新表
        SyncTask->>OldDB: 读取变更
        SyncTask->>NewDB: 读取变更
        SyncTask->>SyncTask: 比对差异
        SyncTask->>NewDB: 修复不一致
    graph LR
        A[启动验证] --> B[获取旧表总数]
        A --> C[获取新表总数]
        B --> D{总数相等?}
        C --> D
        D -- 否 --> E[报错终止]
        D -- 是 --> F[抽样比对]
        F --> G{抽样一致?}
        G -- 否 --> H[定位问题]
        G -- 是 --> I[验证通过]
Python示例:分片迁移脚本
import hashlib

def get_shard_id(user_id, num_shards):
    return int(hashlib.md5(str(user_id).encode()).hexdigest(), 16) % num_shards

def migrate_data(old_shards, new_shard_count):
    for shard_id in old_shards:
        data = fetch_from_old_shard(shard_id)
        for record in data:
            new_shard = get_shard_id(record['id'], new_shard_count)
            insert_into_new_shard(new_shard, record)
预期输出:所有数据被重新分配到新的分片中,且无数据丢失。

















