








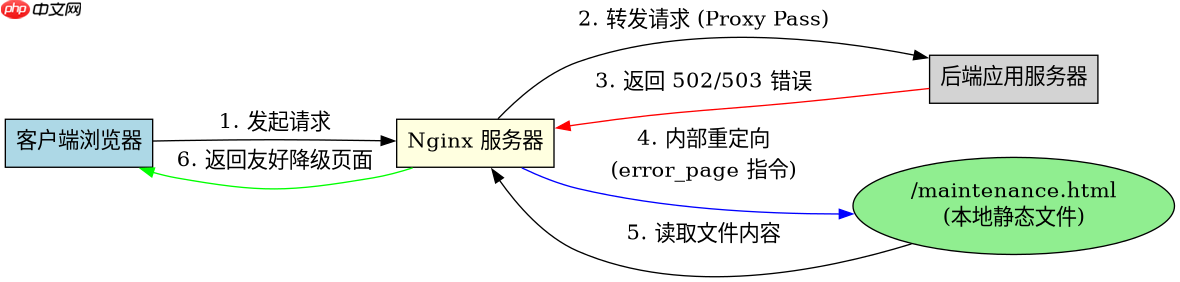
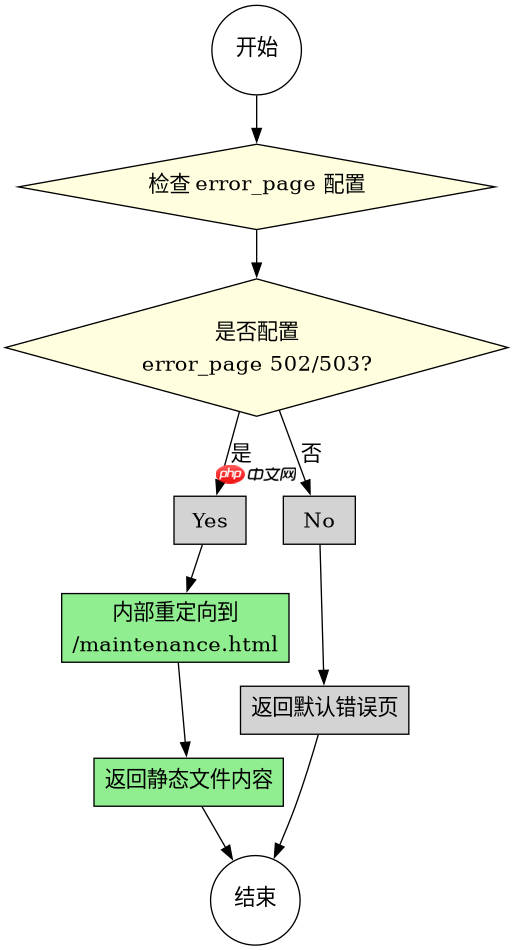
在 nginx 中实现故障转移时自动返回友好的降级页面,核心做法是利用 error_page 指令捕获后端服务不可用时的特定 http 状态码(如 502、503),并将其重定向到本地静态 html 文件。具体操作是在 server 或 location 块中配置 error_page 502 503 /maintenance.html;,同时确保该静态文件路径可通过 root 或 alias 访问,这样当上游服务器宕机或拒绝连接时,nginx 会直接返回预设的友好提示页而非默认的丑陋错误页。
如何配置 error_page 指向本地静态资源
要实现这一功能,必须在 Nginx 配置文件中显式定义错误页面的映射关系,并确保静态文件存在于磁盘上且权限正确。关键在于理解 error_page 指令的行为:它默认执行内部重定向(internal redirect),这意味着请求 URL 不会改变,但内容源变为指定的文件。如果希望用户看到新的 URL,可以添加 = 前缀强制外部重定向,但在降级场景下通常使用内部重定向以保持用户体验的一致性。此外,需要为静态文件创建一个独立的 location 块或使用 try_files 来确保即使主应用崩溃,静态资源也能被正常读取。
server {
    listen 80;
    server_name example.com;

    # 定义根目录
    root /var/www/html;
    index index.html;

    # 关键配置:捕获 502 和 503 错误,重定向到 maintenance.html
    error_page 502 503 /maintenance.html;

    location = /maintenance.html {
        # 确保这个位置可以直接访问静态文件
        internal;
        root /var/www/html;
    }

    location / {
        # 尝试先找静态文件,如果没有则代理到后端
        try_files $uri $uri/ @backend;
    }

    location @backend {
        proxy_pass http://127.0.0.1:8080;
        # 如果后端也挂了,Nginx 会生成 502,触发上面的 error_page
    }
}上述配置中,error_page 502 503 /maintenance.html; 是核心逻辑。当 @backend 中的 proxy_pass 失败时,Nginx 会生成一个 502 Bad Gateway 响应。此时,error_page 指令介入,将请求内部重定向到 /maintenance.html。由于我们在 location = /maintenance.html 中设置了 internal,这防止了用户通过直接访问该 URL 绕过正常的错误处理流程(尽管在某些版本中这不是必须的,但有助于安全)。静态文件 maintenance.html 必须位于 /var/www/html/ 目录下。这种结构确保了无论前端路由如何复杂,只要后端不可用,用户都会看到统一的维护页面。

如何结合 upstream 健康检查优化故障转移体验
除了基本的错误页面返回,优化故障转移体验的关键在于减少 Nginx 向已失效的后端节点发送请求的次数。这可以通过配置 upstream 块中的健康检查机制来实现。虽然 Nginx 开源版没有内置主动健康检查,但可以通过 max_fails 和 fail_timeout 参数模拟被动健康检查。当某个后端节点连续失败次数超过 max_fails 设定的阈值时,Nginx 会在 fail_timeout 指定的时间内将该节点标记为不可用,从而避免立即重试导致更长的用户等待时间。配合 keepalive 连接池管理,可以有效降低因频繁建立 TCP 连接带来的开销,使得故障转移过程更加平滑。
upstream backend_servers {
    server 192.168.1.10:8080 max_fails=3 fail_timeout=30s;
    server 192.168.1.11:8080 max_fails=3 fail_timeout=30s;
    server 192.168.1.12:8080 max_fails=3 fail_timeout=30s;
}

server {
    listen 80;
    server_name example.com;

    error_page 502 503 /maintenance.html;

    location / {
        proxy_pass http://backend_servers;
        proxy_next_upstream error timeout invalid_header http_500 http_502 http_503;
        proxy_next_upstream_tries 2;
    }

    location = /maintenance.html {
        internal;
        root /var/www/html;
    }
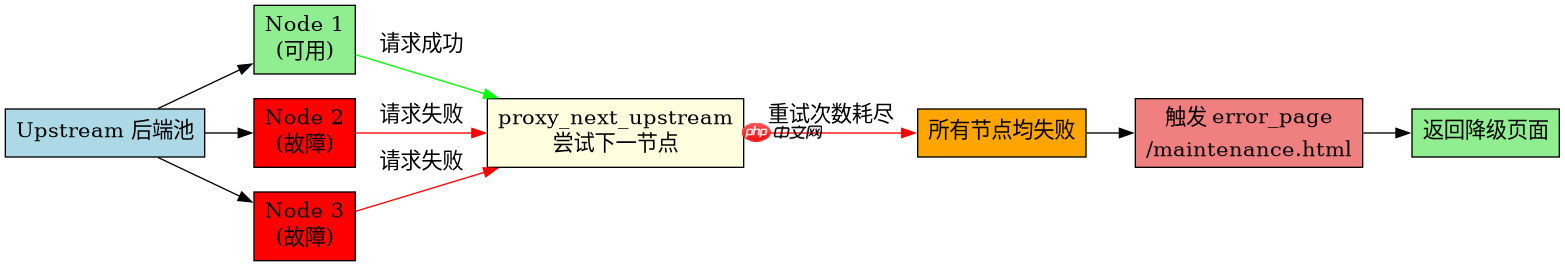
}在这个增强版配置中,upstream 块定义了三个后端服务器。参数 max_fails=3 表示如果一个服务器连续 3 次请求失败,它将在接下来的 30 秒内被视为不可用。fail_timeout=30s 定义了这个时间窗口。同时,proxy_next_upstream 指令告诉 Nginx 在遇到哪些错误时可以尝试下一个上游服务器。这里我们不仅包括 error 和 timeout,还明确列出了 http_500、http_502 和 http_503,确保在这些情况下 Nginx 会先尝试其他健康的后端节点,而不是立即返回错误页面。只有当所有配置的 proxy_next_upstream_tries(此处设为 2)次尝试都失败后,才会最终触发 error_page 返回 /maintenance.html。这种分层策略极大地提高了系统的可用性,让用户在部分节点故障时仍能正常使用服务,只有在全部节点失效时才看到降级页面。
当所有后端节点均不可用时 error_page 的具体行为是什么
当所有配置的 upstream 节点均处于不可用状态,或者 proxy_next_upstream 尝试次数耗尽后,Nginx 的最终行为完全取决于 error_page 指令的配置。在这种情况下,Nginx 会生成一个最终的 HTTP 响应,其状态码通常为 502 或 503,具体取决于触发错误的类型。如果配置了 error_page 502 503 /maintenance.html;,Nginx 会将这个最终错误内部重定向到 /maintenance.html。此时,/maintenance.html 的内容将被作为响应体发送给客户端,而响应的状态码可能会保留原始的 502/503,或者根据 Nginx 版本和配置的不同,可能返回 200 OK(如果 error_page 被视为一个新的成功请求)。为了确保一致性,建议在 location = /maintenance.html 中不设置额外的 return 指令,而是依赖 error_page 的默认行为。如果希望强制返回 200 状态码以隐藏错误信息,可以在 location = /maintenance.html 中添加 return 200;,但这可能会导致搜索引擎爬虫误判页面状态。因此,保留原始错误码并展示友好内容是更常见的做法。


















