








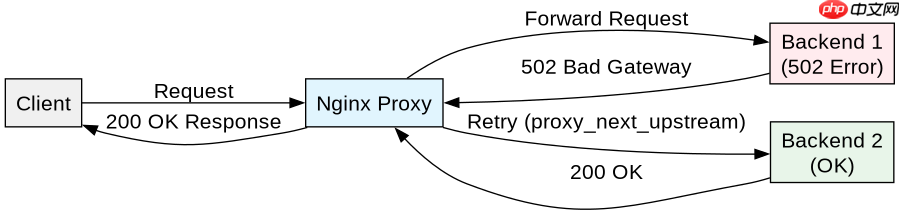
在 nginx 中处理 upstream 返回的 502 bad gateway 错误,最直接且有效的做法是配置 proxy_next_upstream 指令。该指令允许 nginx 在遇到特定错误(如连接失败、超时或上游返回 502/504)时,自动将请求转发给集群中的下一个健康节点,从而对客户端实现透明重试。通过合理设置 proxy_next_upstream 和 max_fails,可以确保在部分后端服务不可用时,流量能自动漂移至正常运行的实例,避免单点故障导致的用户报错。
如何配置 proxy_next_upstream 实现自动故障转移?
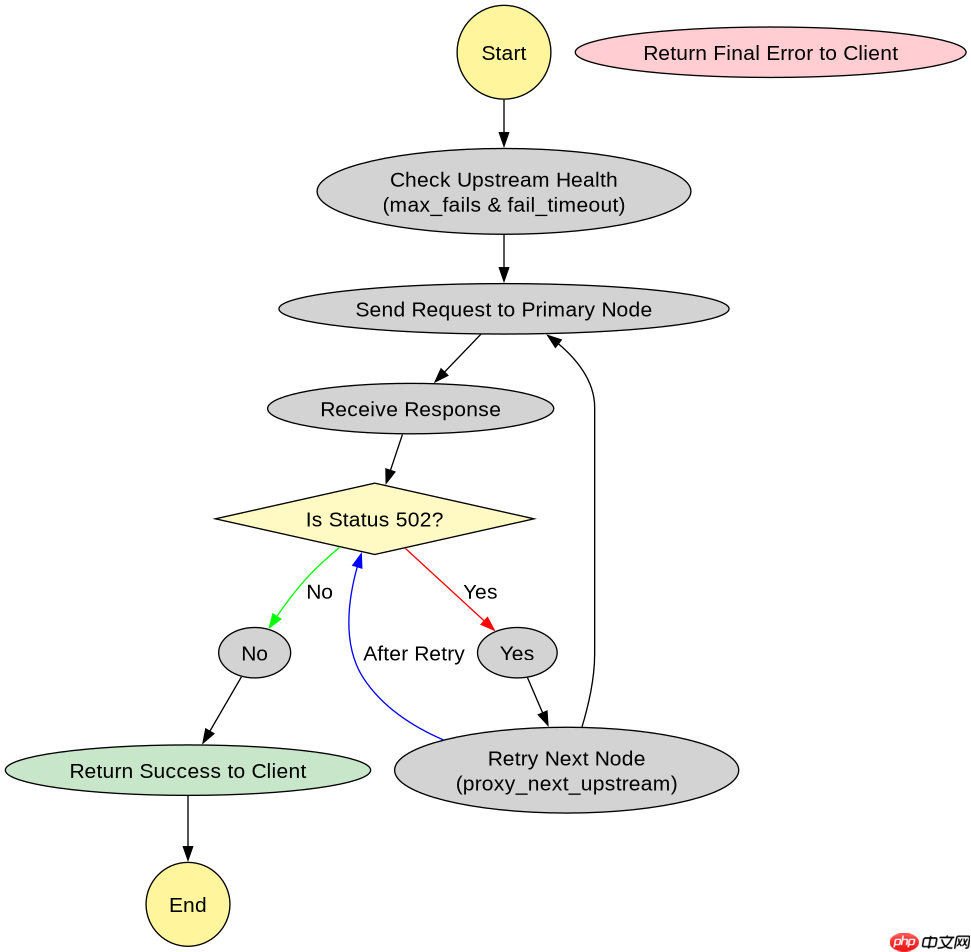
要实现自动故障转移,需要在 location 块中启用 proxy_next_upstream 并指定触发条件。默认情况下,Nginx 仅在连接失败或超时时才会重试,不会主动处理 502 状态码。因此,必须显式添加 error 参数,它涵盖了 502、503、504 等网关错误。同时,配合 upstream 块中的 max_fails 和 fail_timeout,可以控制 Nginx 标记后端为“不可用”的频率和时间窗口,防止向已宕机的节点持续发送请求。
upstream backend {
    server 192.168.1.10:8080 max_fails=3 fail_timeout=30s;
    server 192.168.1.11:8080 max_fails=3 fail_timeout=30s;
}

server {
    listen 80;
    location /api/ {
        proxy_pass http://backend;
        # 关键配置:遇到 error (含502), timeout, 或 nohealth 时重试
        proxy_next_upstream error timeout invalid_header http_502 http_504;
        # 限制每个请求最多重试次数,防止无限循环
        proxy_next_upstream_tries 2;
    }
}
上述配置中,http_502 明确指定了当上游返回 502 状态码时触发重试。如果第一个节点 192.168.1.10 返回 502,Nginx 会立即尝试 192.168.1.11。若两个节点均失败,则根据 proxy_next_upstream_tries 的限制,最终向客户端返回最后一个节点的错误响应。这种机制确保了高可用性,但需注意,对于非幂等请求(如 POST),需评估业务层是否支持重复提交。

如何处理重试耗尽后的最终错误响应?
当所有配置的 upstream 节点均返回 502 或重试次数耗尽后,Nginx 会将最后一个错误响应传递给客户端。为了提升用户体验,通常建议自定义错误页面或使用 error_page 指令拦截这些错误。通过捕获 502 状态码,可以返回一个友好的提示页面,或者重定向到维护页,而不是直接暴露原始的 Nginx 错误信息。此外,还可以结合日志记录,便于排查具体是哪个 upstream 节点频繁出错。

server {
    listen 80;

    # 定义错误页面映射
    error_page 502 /502.html;
    location = /502.html {
        root /usr/share/nginx/html;
        internal; # 仅内部访问,防止外部直接请求
    }

    location /api/ {
        proxy_pass http://backend;
        proxy_next_upstream error timeout http_502;
        proxy_next_upstream_tries 2;

        # 可选:记录详细的重试日志
        access_log /var/log/nginx/api_access.log main if=$retry_count;
    }
}
在上述配置中,error_page 502 /502.html 告诉 Nginx 当最终决定返回 502 时,不要使用默认的错误页,而是读取本地文件 /usr/share/nginx/html/502.html。internal 指令确保该页面只能通过内部错误处理机制访问,不能通过 URL 直接请求,增强了安全性。开发者应确保 /usr/share/nginx/html/502.html 文件存在且内容简洁友好。通过这种方式,即使后端全部宕机,前端也能获得一致的体验,同时运维团队可通过分析 Nginx 错误日志定位具体的故障节点。
当 upstream 节点间歇性返回 502 时,如何优化重试策略?
在实际生产中,upstream 节点可能因负载过高或短暂重启而间歇性返回 502。此时,单纯依赖 proxy_next_upstream 可能导致请求在多个节点间反复横跳,增加延迟甚至引发雪崩。优化策略包括:一是缩短 fail_timeout 时间,让 Nginx 更快地剔除暂时过载的节点;二是引入 keepalive 连接复用,减少 TCP 握手开销,降低重试时的延迟;三是结合应用层的熔断机制,如 Sentinel 或 Hystrix,在 Nginx 层之外进行更细粒度的流量控制。此外,可监控 Nginx 的 upstream_response_time 和 status_code,动态调整 max_fails 阈值,实现自适应容错。


















