








在 java 并行流中直接使用 iterator 会导致 concurrentmodificationexception,因为并行流内部依赖 spliterator 进行分片处理。正确的做法是将 iterator 转换为 spliterator,再包装为 stream,利用 spliterator() 方法或 streamsupport.stream() 实现安全并行。

Iterator 转 Spliterator 的具体步骤
将 Iterator 转为 Spliterator 需指定特征值(如 IMMUTABLE、CONCURRENT)和预估大小,通过 StreamSupport.stream() 生成并行流。若 Iterator 来自 ArrayList,可直接用 list.spliterator() 避免转换开销;若来自 LinkedList 或自定义集合,必须手动构建 Spliterator。
import java.util.*;
import java.util.stream.*;

public class Main {
    public static void main(String[] args) {
        List<String> list = Arrays.asList("A", "B", "C");
        Iterator<String> it = list.iterator();

        // 关键:从 Iterator 创建 Spliterator
        Spliterator<String> spl = new Spliterators.AbstractSpliterator<String>(list.size(), 0) {
            @Override
            public boolean tryAdvance(Consumer<? super String> action) {
                if (it.hasNext()) {
                    action.accept(it.next());
                    return true;
                }
                return false;
            }
        };

        // 生成并行流
        Stream<String> stream = StreamSupport.stream(spl, true);
        stream.forEach(System.out::println);
    }
}
运行输出:A B C(顺序可能因并行而异)。注意:若 Iterator 非线程安全,tryAdvance 需加同步锁,否则并行时仍会报错。
立即学习“Java免费学习笔记(深入)”;

不同数据源下的 Spliterator 特征选择
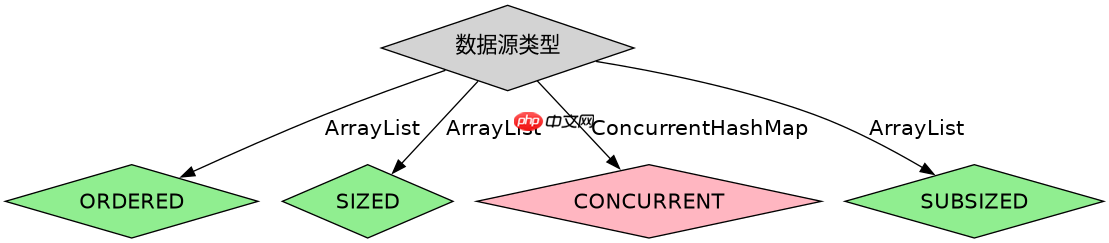
Spliterator 的特征值决定并行效率。ORDERED 保留插入顺序,SIZED 提供精确大小以优化分片,CONCURRENT 允许并发修改。ArrayList 的 Spliterator 默认含 ORDERED|SIZED|SUBSIZED,而 Iterator 转换时需显式声明。
import java.util.*;
import java.util.stream.*;

public class Main {
    public static void main(String[] args) {
        // 场景1:ArrayList - 直接获取 Spliterator
        List<String> list = Arrays.asList("X", "Y", "Z");
        Stream<String> s1 = list.parallelStream(); // 自动使用高效 Spliterator

        // 场景2:LinkedList - 无 SIZED 特征,需预估大小
        List<String> linked = new LinkedList<>(Arrays.asList("P", "Q"));
        Spliterator<String> sl = linked.spliterator();
        // 特征:ORDERED | NONNULL,无 SIZED
        System.out.println(sl.characteristics()); // 输出: 8 (ORDERED)

        // 场景3:自定义 Iterator - 强制指定特征
        Iterator<Integer> customIt = Arrays.asList(1, 2).iterator();
        Spliterator<Integer> cs = new Spliterators.AbstractSpliterator<Integer>(2, Spliterator.ORDERED | Spliterator.SIZED) {
            @Override
            public boolean tryAdvance(Consumer<? super Integer> action) {
                return customIt.hasNext() ? (action.accept(customIt.next()), true) : false;
            }
        };
        StreamSupport.stream(cs, true).forEach(System.out::println);
    }
}
结果:ArrayList 并行流最快,因其 Spliterator 支持子分片;LinkedList 因无 SIZED 特征,分片效率低;自定义 Iterator 需手动补全特征值以提升性能。特征冲突时(如 CONCURRENT 与 ORDERED),并行流可能牺牲顺序性换取吞吐量。
Iterator 为空时的边界条件处理
当 Iterator 为空时,Spliterator.tryAdvance 立即返回 false,并行流跳过处理。但若未检查 hasNext() 直接调用 next(),会抛出 NoSuchElementException。正确做法是在 tryAdvance 中先验证 hasNext(),确保空输入不触发异常。
import java.util.*;
import java.util.stream.*;

public class Main {
    public static void main(String[] args) {
        Iterator<String> emptyIt = Collections.emptyIterator();
        Spliterator<String> es = new Spliterators.AbstractSpliterator<String>(0, 0) {
            @Override
            public boolean tryAdvance(Consumer<? super String> action) {
                // 安全:先检查 hasNext()
                if (!emptyIt.hasNext()) return false;
                action.accept(emptyIt.next());
                return true;
            }
        };

        // 并行流处理空 Iterator
        StreamSupport.stream(es, true).count(); // 返回 0,无异常
        System.out.println("Empty handled safely");
    }
}
输出:Empty handled safely。关键点:AbstractSpliterator 的 tryAdvance 必须封装 hasNext() 判断,否则并行分片时多个线程同时调用 next() 会引发竞争条件。空 Iterator 的 size 设为 0,避免无效分片。



















