








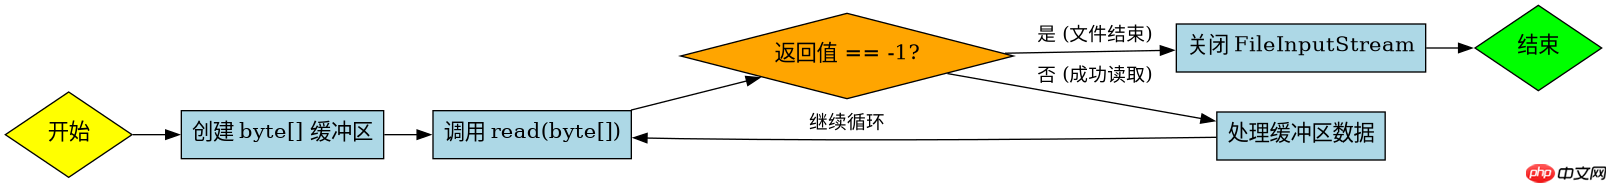
在 java 中使用 fileinputstream 读取字节数组时,核心做法是调用 read(byte[] b) 方法,将数据填充到预先分配的字节缓冲区中。该方法会尝试从输入流中读取最多 b.length 个字节的数据并存入数组,返回实际读取的字节数;若到达文件末尾则返回 -1。通过循环调用此方法并检查返回值,即可完整读取文件内容。
如何指定读取的起始位置和长度
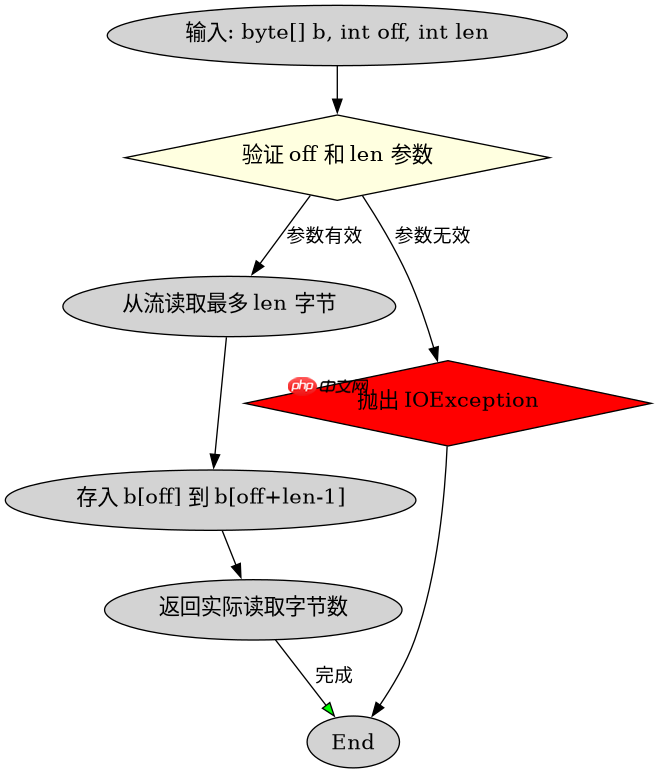
如果需要从字节数组的特定位置开始存储数据或指定读取长度,应使用重载方法 read(byte[] b, int off, int len)。其中 off 参数指定数组中的起始偏移量,len 参数指定最大读取字节数。该方法同样返回实际读取的字节数,适用于需要精细控制内存布局的场景。

如何处理读取过程中的异常与资源释放
在实际开发中,必须处理 IOException 并确保流被正确关闭。推荐使用 try-with-resources 语句自动管理资源,避免资源泄漏。当读取过程中发生 I/O 错误时,程序会抛出异常,此时已读取的部分数据可能不完整,需根据业务逻辑决定是重试、截断还是报错。
立即学习“Java免费学习笔记(深入)”;
基于 read() 返回值判断文件结束的具体问题
当 read() 方法返回 -1 时,表示已达到输入流的末尾,这是判断文件读取完成的唯一可靠依据。在循环中,只有当返回值大于 0 时才处理数组中的数据,因为返回值等于 0 可能表示未读取任何字节(如空缓冲区),但不一定代表结束。正确处理这一返回值能避免死循环或数据错位。


















