








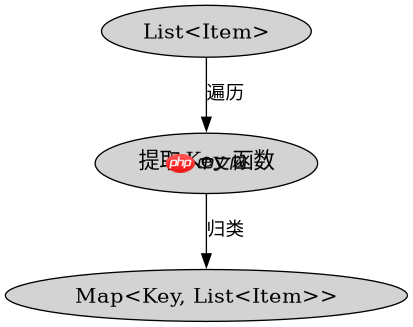
java hashmap 分组聚合的核心做法是遍历源数据,以目标字段为 key 构建 mapcollectors.groupingby() 进行声明式处理,或者使用传统的增强 for 循环配合 computeifabsent 方法实现命令式逻辑。

Stream groupingBy 如何按字段分类
使用 Collectors.groupingBy() 可以自动完成分组操作,返回一个 Map,其中 Key 是分组依据的值,Value 是该组所有元素的列表。这种方法代码简洁,适合大多数场景。
import java.util.*;
import java.util.stream.Collectors;

public class GroupByDemo {
    public static void main(String[] args) {
        List<String> items = Arrays.asList("apple", "banana", "apple", "orange", "banana", "apple");

        // 按字符串长度分组
        Map<Integer, List<String>> grouped = items.stream()
                .collect(Collectors.groupingBy(String::length));

        System.out.println(grouped);
    }
}
传统循环如何实现自定义聚合
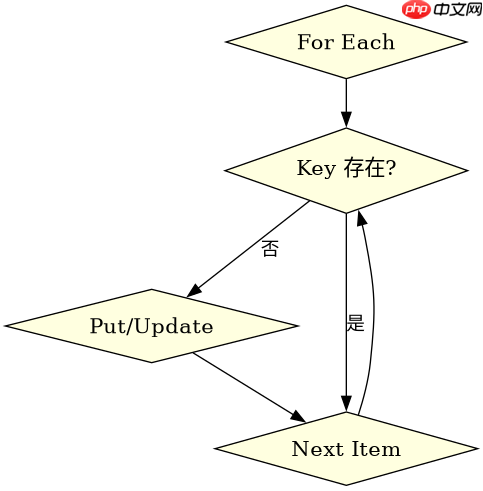
当需要更复杂的聚合逻辑(如求和、计数或合并对象)时,使用增强 for 循环结合 Map.computeIfAbsent() 更加灵活。这种方式避免了 Stream 的开销,且能直接操作原始数据结构。

立即学习“Java免费学习笔记(深入)”;
import java.util.*;

public class CustomAggregation {
    public static void main(String[] args) {
        List<String> items = Arrays.asList("apple", "banana", "apple", "orange", "banana", "apple");
        Map<Integer, Integer> countMap = new HashMap<>();

        for (String item : items) {
            int key = item.length();
            // 如果键不存在则初始化为0,然后自增
            countMap.put(key, countMap.getOrDefault(key, 0) + 1);
        }

        System.out.println(countMap);
    }
}
如何处理分组后的空值或默认行为
在分组过程中,如果源数据包含 null 值,groupingBy 会将其作为一个单独的 Key(值为 null)存入结果 Map 中。而在传统循环中,若未做判空处理,可能会抛出 NullPointerException 或导致逻辑错误。因此,在处理前过滤掉 null 值是保证程序健壮性的关键步骤。



















