








判断晋升失败的核心依据是观察老年代(old gen)在minor gc后是否出现空间不足,导致gc无法将存活对象移动到老年代而抛出异常。具体做法是检查gc日志中是否存在 java.lang.outofmemoryerror: java heap space 错误,或者在young gc日志中发现 promotion failed 或 ergonomics 相关的拒绝晋升提示。当survivor区不足以容纳所有从eden区和from survivor区复制过来的存活对象时,jvm会尝试直接将这些大对象或过多对象“溢出”到老年代;如果此时老年代也没有足够连续空间容纳这些对象,就会触发晋升失败。
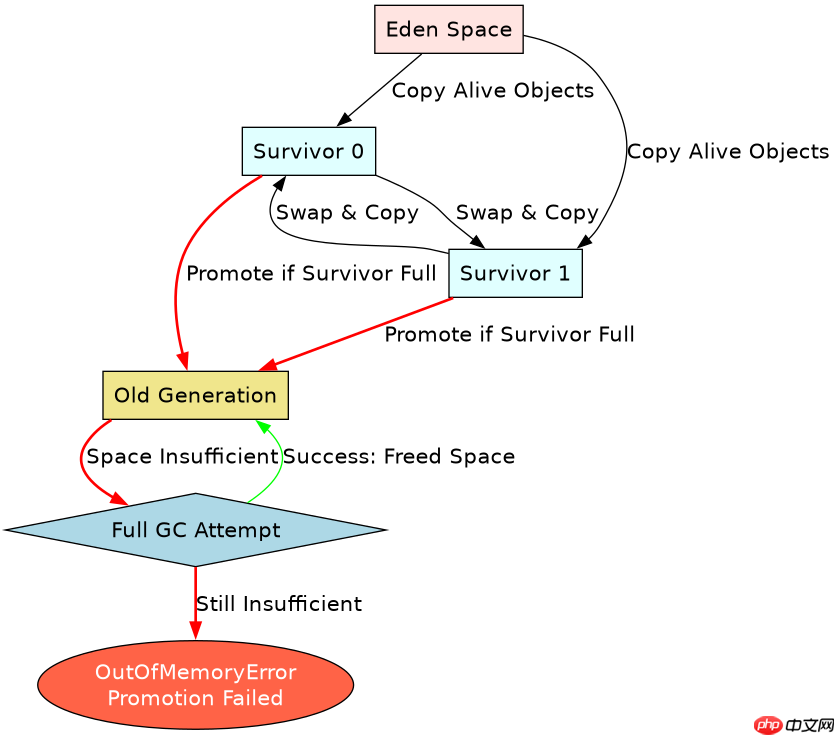
Young GC日志中如何识别晋升失败的直接证据
在Young GC(Minor GC)的日志输出中,最直接的晋升失败证据通常出现在日志的末尾部分,特别是涉及内存分配统计的区域。现代HotSpot JVM(如Java 8及以后版本)会在日志中明确记录晋升尝试的结果。如果发生晋升失败,你通常会看到类似 Promotion failed 或 Allocation failure 伴随老年代空间不足的提示。此外,日志中的 G1 Old Generation 或 PS Young Generation 等区域的容量变化也能辅助判断:如果Young GC后,老年代的占用量没有按预期增加(因为对象没移过去),或者反而出现了老年代扩容失败后的OOM,这就是关键信号。需要注意的是,单纯的 Allocation Failure 并不一定意味着晋升失败,它可能只是普通的Young GC触发,必须结合后续的OOM或明确的失败标记来确认。

import java.util.ArrayList;
import java.util.List;

public class PromotionFailureDemo {
    // 设置堆大小以便观察:-Xms10m -Xmx10m -Xmn5m -XX:+PrintGCDetails
    public static void main(String[] args) {
        List<byte[]> list = new ArrayList<>();
        try {
            // 循环分配大对象,填满Young Gen和Survivor,迫使对象进入Old Gen
            for (int i = 0; i < 100; i++) {
                // 每个数组约1MB,Young Gen总共5MB,很快会溢出到Old Gen
                byte[] data = new byte[1024 * 1024];
                list.add(data);
                System.out.println("Allocated chunk " + i);
            }
        } catch (OutOfMemoryError e) {
            System.err.println("Caught OOM: " + e.getMessage());
            e.printStackTrace();
        }
    }
}
上述代码通过不断分配大于Survivor区容量的对象,强制JVM进行晋升。运行该程序并开启详细GC日志(-XX:+PrintGCDetails),你将观察到Young GC频繁触发,随后老年代空间被迅速消耗。当老年代剩余空间不足以容纳新晋升的对象时,JVM将抛出 OutOfMemoryError。在日志中,你会看到类似以下的片段:[Full GC (Ergonomics) ...] [Tenured: 0K->...] 或者更直接的 [GC (Allocation Failure) [PSYoungGen: ... -> ...] [ParOldGen: ... -> ...] OutOfMemoryError。重点查找 ParOldGen 或 G1 Old 区域在Young GC期间是否报告了 promotion attempt failed 或直接导致Full GC后仍无法回收的OOM。
Full GC与老年代空间分配担保机制的关系
晋升失败往往与JVM的“空间分配担保”(Space Allocation Guarantee)机制紧密相关。在Parallel Scavenge或Parallel Old垃圾收集器中,每次Minor GC前,JVM会检查老年代的剩余可用空间是否大于之前所有Minor GC中晋升到老年代的平均大小。如果小于,则直接发起Full GC;如果大于,则正常进行Minor GC。然而,如果在Minor GC过程中,实际晋升的对象数量远超平均值,导致老年代空间瞬间不足,就会发生晋升失败。此时,JVM会尝试进行一次Full GC来腾出空间,但如果Full GC后老年代依然没有足够空间,最终将抛出OOM。因此,分析晋升失败时,不仅要关注Young GC日志,还要看紧随其后的Full GC日志。如果Full GC日志显示老年代回收效率极低(例如回收前后占用量变化不大),且随后立即出现OOM,这进一步证实了晋升失败导致的堆空间耗尽。理解这一机制有助于区分是单纯的内存泄漏还是由于对象生命周期管理不当导致的临时性晋升压力过大。

立即学习“Java免费学习笔记(深入)”;
// 模拟高频率短命对象与大对象混合场景,加剧晋升压力
import java.util.concurrent.atomic.AtomicInteger;

public class MixedAllocationStress {
    private static final AtomicInteger counter = new AtomicInteger(0);

    public static void main(String[] args) throws InterruptedException {
        // -Xms20m -Xmx20m -Xmn10m -XX:MaxTenuringThreshold=1 -XX:+PrintGCDetails
        while (true) {
            // 创建大量短命对象,填满Eden
            byte[] shortLived = new byte[1024];

            // 偶尔创建大对象,直接尝试进入Old Gen
            if (counter.incrementAndGet() % 10 == 0) {
                byte[] bigObj = new byte[2 * 1024 * 1024]; // 2MB
                // 强引用保持,防止被回收
                Thread.sleep(10);
            }
            // 快速迭代,模拟高并发分配
        }
    }
}
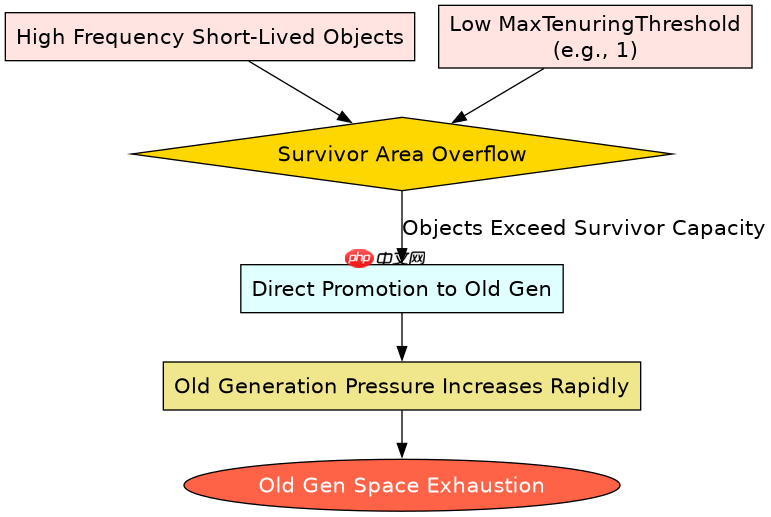
在MixedAllocationStress示例中,通过调整-XX:MaxTenuringThreshold=1,我们强制对象在经历一次Young GC后就尝试晋升到老年代。这种极端设置会迅速填满老年代,从而更容易复现晋升失败。运行此代码时,GC日志将显示频繁的Young GC,且每次Young GC后老年代使用率都会显著上升。当老年代接近满载时,日志中会出现 Allocation Failure 并触发Full GC。如果Full GC无法释放足够空间,系统将抛出OOM。通过分析这些日志序列,可以清晰地看到晋升失败是如何一步步导致系统崩溃的,从而验证了空间分配担保机制在实际运行中的行为边界。
基于Survivor区满溢条件的具体问题分析
基于程序中Survivor区满溢这一具体输入条件,晋升失败的本质是Survivor区无法容纳所有存活对象,导致JVM不得不将部分或全部存活对象直接放入老年代。如果此时老年代空间不足,即发生晋升失败。在上述代码示例中,当MaxTenuringThreshold设置为1时,几乎所有存活过Eden区的对象都会在第一次Young GC后被晋升。如果Survivor区很小(例如仅几MB),而存活对象总量超过这个值,多余的存活对象将直接“跳过”Survivor区进入老年代。这种现象在日志中表现为Young GC期间老年代占用量的突增,而非渐进式增长。开发者应特别注意,晋升失败并非总是由大对象引起,大量小对象的突然存活也可能导致此问题。通过监控Survivor区的利用率和老年代的晋升速率,可以提前预警潜在的晋升失败风险,并通过调整堆大小、Survivor比例或对象生命周期来优化。


















