








utf-16 是 java 内部处理字符串的编码格式,它将字符映射为 16 位(2 字节)的代码单元序列。在 java 中,`char` 类型占用 2 个字节,`string` 类由 `char[]` 数组构成,因此字符串在内存中直接以 utf-16be(大端序)存储。这种设计使得 java 能够高效地通过索引访问字符,但对于超出基本多文种平面(bmp)的辅助平面字符(如 emoji),会使用两个 `char`(即 4 字节)组成的代理对来表示。
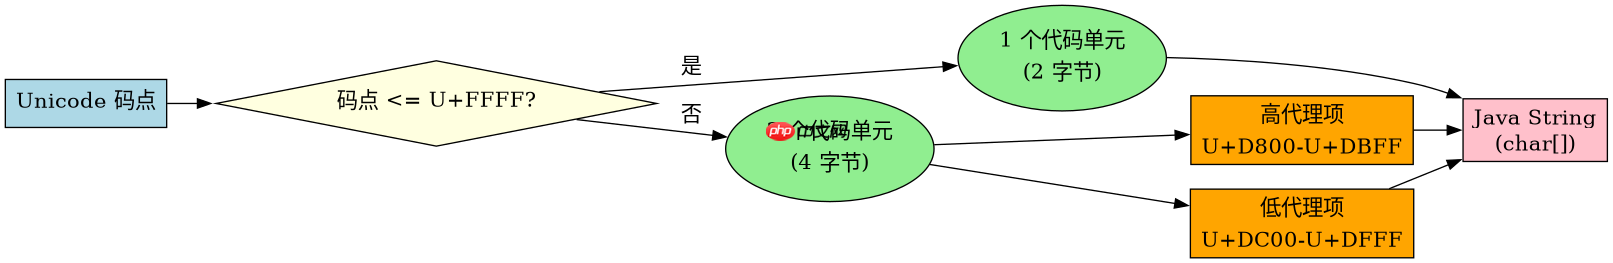
UTF-16 如何处理 BMP 与辅助平面字符
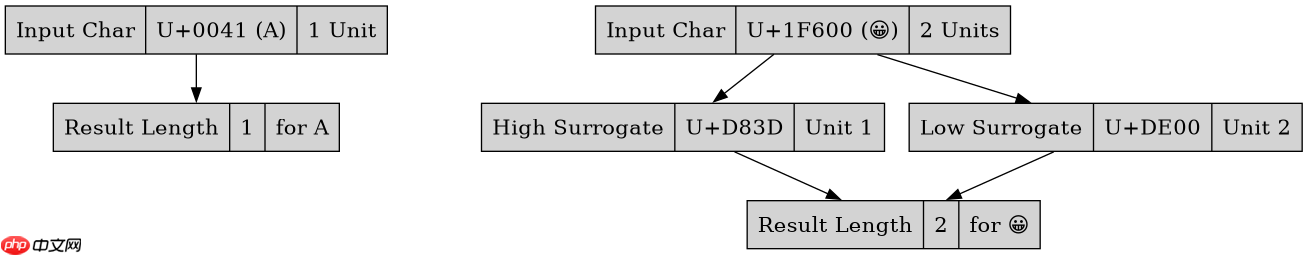
UTF-16 根据 Unicode 码点范围决定使用一个还是两个代码单元。对于 U+0000 到 U+FFFF 的字符,直接使用其码点作为 16 位值;对于 U+10000 及以上的字符,则通过计算偏移量生成高代理项和低代理项。Java 的 `String.charAt()` 方法返回的是单个代码单元,若需获取完整字符应使用 `codePointAt()`。
public class Utf16Demo {
    public static void main(String[] args) {
        // BMP 字符:A (U+0041)
        char c1 = 'A';
        System.out.println("Char A: " + c1);
        System.out.println("Code Point: " + Integer.toHexString(c1));

        // 辅助平面字符:Emoji (U+1F600)
        String emoji = "\uD83D\uDE00";
        int cp = emoji.codePointAt(0);
        System.out.println("Emoji Code Point: " + Integer.toHexString(cp));
        System.out.println("Length in chars: " + emoji.length());
    }
}
UTF-16 与大端序、小端序及 BOM 的关系
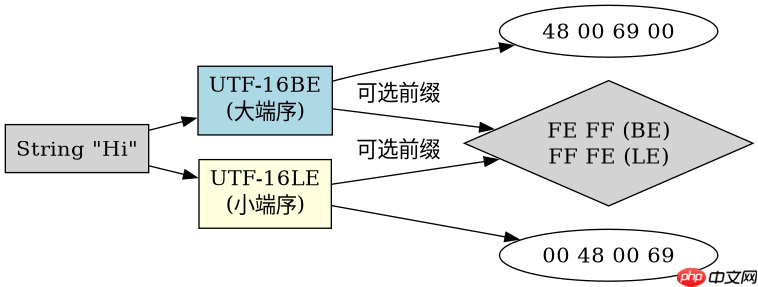
UTF-16 存在两种字节序:大端序(UTF-16BE)和小端序(UTF-16LE)。Java 默认使用大端序存储字符串。当进行序列化或网络传输时,若未指定字节序,可能导致乱码。BOM(Byte Order Mark)用于标识字节序,但在 Java 内部字符串中通常不包含 BOM,仅在文件 I/O 或特定编码转换时出现。

立即学习“Java免费学习笔记(深入)”;
import java.nio.charset.StandardCharsets;

public class ByteOrderDemo {
    public static void main(String[] args) {
        String text = "Hi";
        byte[] beBytes = text.getBytes(StandardCharsets.UTF_16BE);
        byte[] leBytes = text.getBytes(StandardCharsets.UTF_16LE);

        System.out.print("BE bytes: ");
        for (byte b : beBytes) System.out.printf("%02X ", b);
        System.out.println();

        System.out.print("LE bytes: ");
        for (byte b : leBytes) System.out.printf("%02X ", b);
        System.out.println();
    }
}
为什么 Java 字符串长度可能不等于字符数
由于辅助平面字符由两个 `char` 组成,`String.length()` 返回的是代码单元数量而非视觉字符数。例如,一个 Emoji 会贡献 2 给 `length()`,但只算作 1 个字符。若需准确计数,应使用 `codePointCount()` 或 `String::codePoints().count()`。这一特性在涉及文本处理、UI 显示或数据库存储时需特别注意,以避免长度计算错误。


















